Een AI-assistent die af en toe vragen van klanten beantwoordt, heeft andere behoeften dan een service die de hele dag verzoeken verwerkt. De juiste keuze begint bij de taak, de verwachte vraag en wie de technologie beheert - niet bij de grootste GPU.
Een GPU is een krachtige chip die wordt gebruikt om veel AI-taken uit te voeren. Een AI-model is de software die deze taken uitvoert. Een API is een verbinding waarmee uw applicatie een AI-service kan gebruiken zonder het model zelf te draaien.
Wat kiest u eigenlijk?
Met een beheerde AI-API krijgt u toegang tot een direct bruikbare service. Met gedeelde of dedicated GPU's huurt u computercapaciteit en moet u de AI-software mogelijk zelf beheren.
Een API-service kan op gedeelde of dedicated hardware draaien. De belangrijkste vragen zijn wie de service beheert en welke capaciteit uw workload vereist.
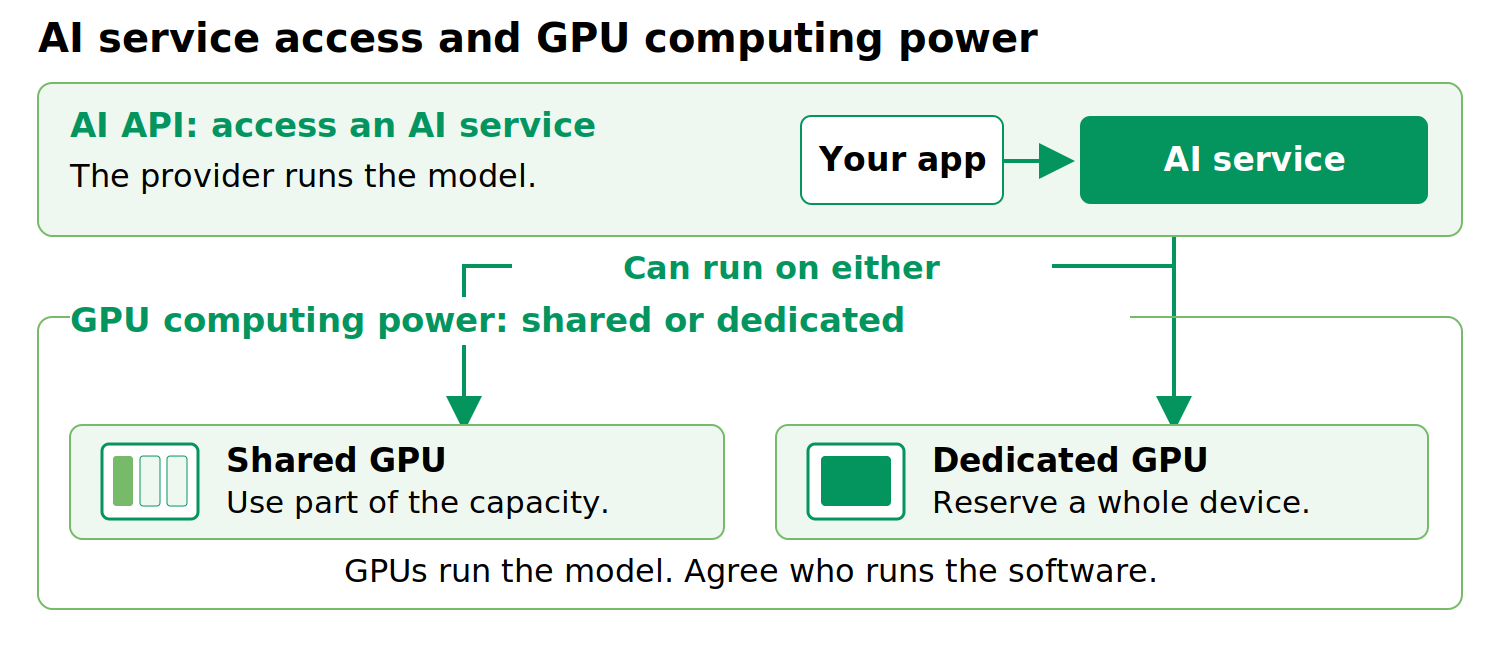
Afbeelding 1. Twee verschillende beslissingen: de AI-service die u gebruikt en de GPU-capaciteit eronder.
Drie manieren om te beginnen
Optie 1: AI als service gebruiken
Met een beheerde API kan uw team een applicatie verbinden met een ondersteund model. De provider voert het model uit; u blijft verantwoordelijk voor de applicatie, toegangsrechten en het controleren of de antwoorden goed genoeg zijn.
Dit kan geschikt zijn voor onzekere of wisselende vraag. Controleer voordat u zich vastlegt de gebruikslimieten, responstijden tijdens drukke perioden en wat er gebeurt wanneer de provider een model wijzigt. Vraag ook waar verzoeken naartoe gaan, wie er toegang toe heeft en hoelang gegevens worden bewaard.
Optie 2: GPU-capaciteit delen
Gedeelde GPU-services kunnen resources op verschillende manieren toewijzen, waaronder hardwarepartitionering of time-sharing. Deze benaderingen bieden verschillende niveaus van isolatie en voorspelbaarheid van prestaties. Vraag de provider welke resources aan uw workload worden toegewezen en hoe andere gebruikers de prestaties kunnen beïnvloeden.
Delen kan op verschillende manieren. Sommige services bieden een hardwarematig afgescheiden deel; andere delen de verwerkingstijd. Deze bieden niet dezelfde bescherming of prestaties. De documentatie van NVIDIA maakt onderscheid tussen deze benaderingen.
Vraag hoeveel geheugen en verwerkingscapaciteit u krijgt, of andere klanten uw werk kunnen beïnvloeden en wie de AI-software onderhoudt. Alleen “gedeeld” geeft geen antwoord op deze vragen.
Optie 3: Een GPU reserveren voor uw team
Een dedicated GPU reserveert een volledige chip voor uw werk, maar niet noodzakelijk de hele server. Dit is het overwegen waard bij een stabiele vraag, grotere modellen of applicaties die een speciaal geconfigureerde AI-omgeving nodig hebben.
U hebt nog steeds iemand nodig om de software te installeren, bij te werken, te monitoren en te herstellen, tenzij deze services zijn inbegrepen. Een dedicated GPU is niet automatisch sneller, veiliger of juridisch conform. Test de volledige service, inclusief wat er gebeurt bij een storing.
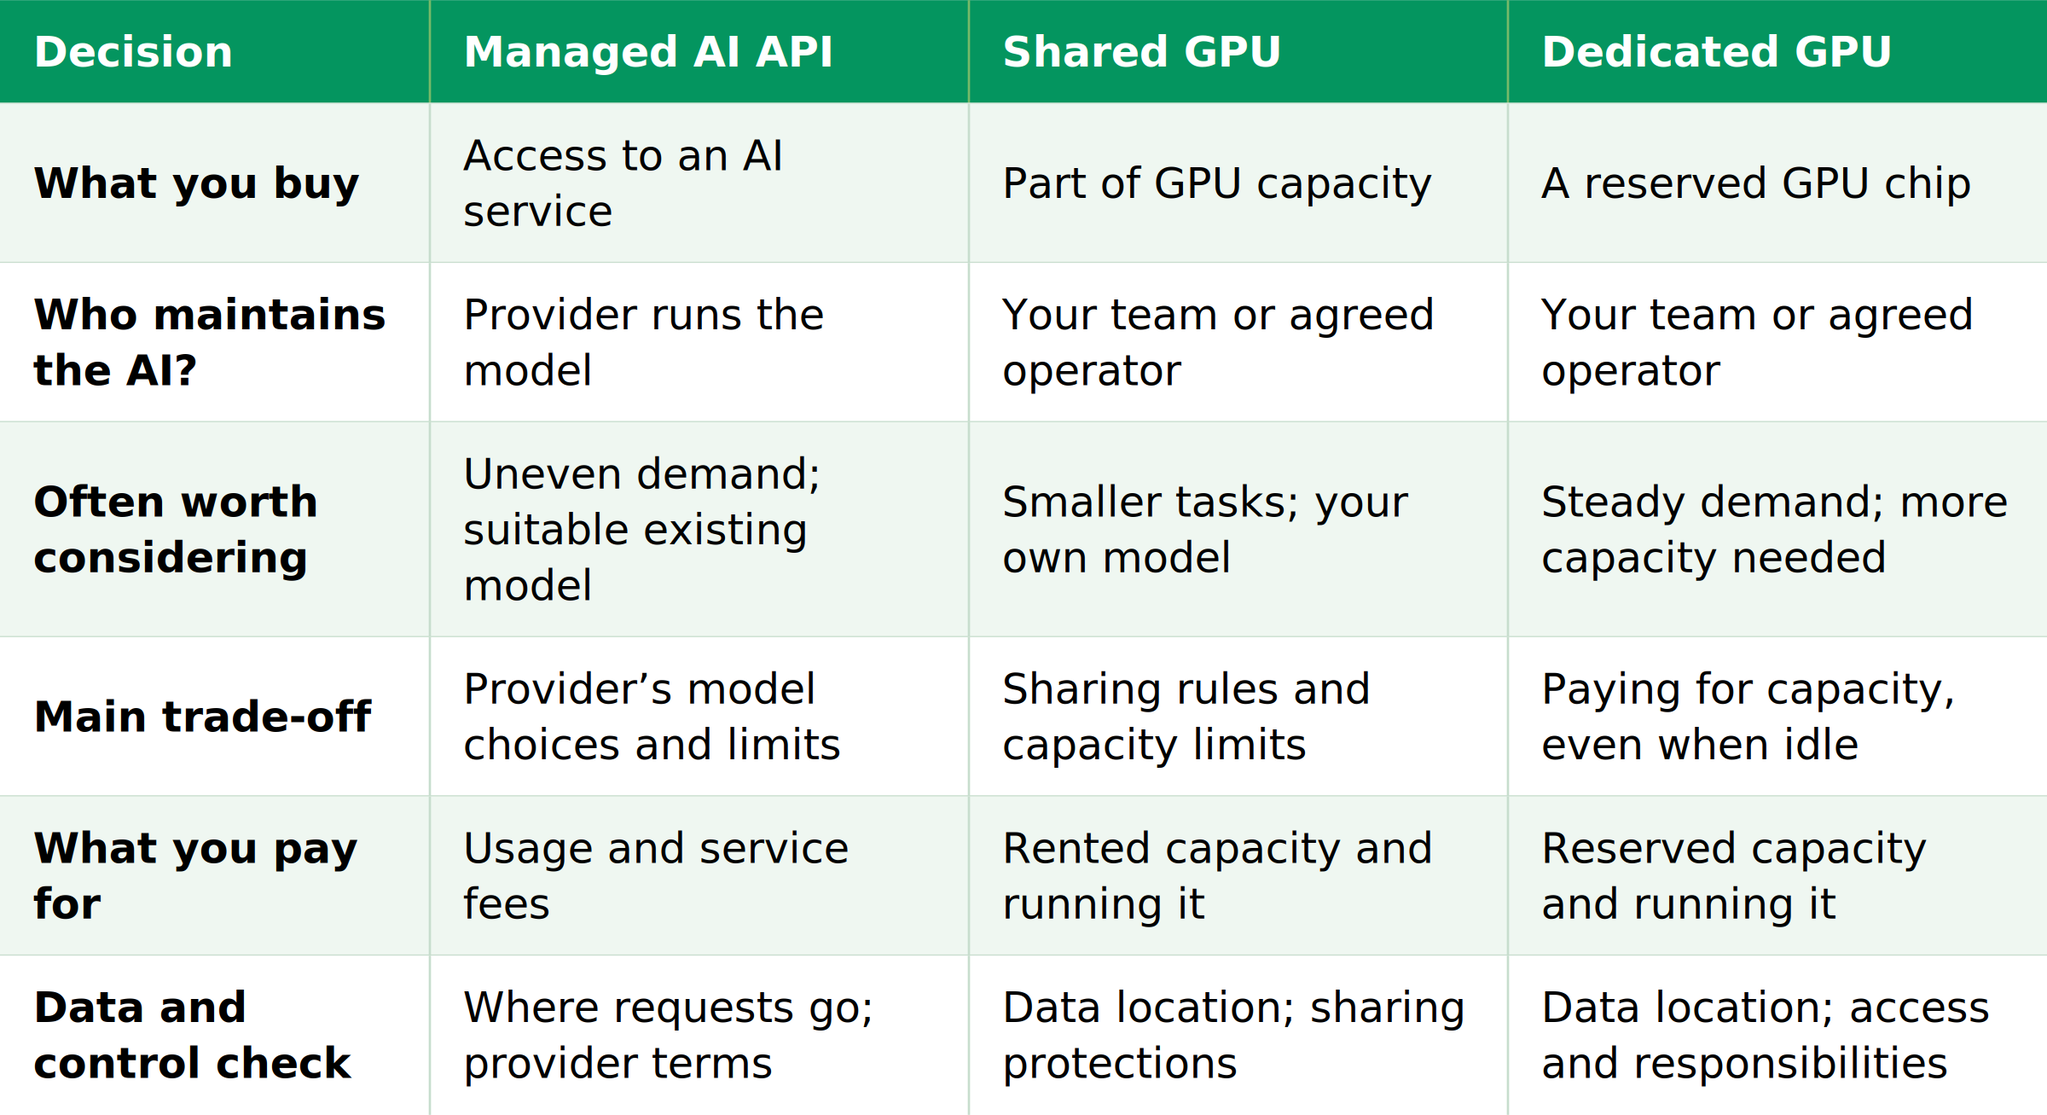
Vergelijk de opties in één oogopslag
Ga voor de onderstaande GPU-opties ervan uit dat uw team de AI-software uitvoert, tenzij u een aparte beheerde service aanschaft.
Controleer wat de taak echt nodig heeft
Begin met bruikbare antwoorden, niet met technische specificaties. Probeer realistische taken uit en bepaal welke kwaliteit acceptabel is, hoelang mensen kunnen wachten en hoeveel mensen de service tegelijk kunnen gebruiken.
Geheugen is ook belangrijk. Een model dat op een GPU past voor één kort verzoek, heeft mogelijk meer geheugen nodig voor lange documenten of meerdere gelijktijdige gebruikers. Vraag uw technische team of provider om de volledige workload te controleren.
Timing beïnvloedt de beslissing. Verwerking gedurende de nacht kan in een wachtrij wachten; een klant die op een live antwoord wacht meestal niet. Test zowel drukke perioden als een rustige demonstratie.
Het aanpassen of trainen van een model kan andere resources vereisen dan het simpelweg gebruiken ervan. Controleer haalbaarheid, softwarecompatibiliteit en modell icenties voordat u hiervoor capaciteit huurt.
Vergelijk de totale kosten
Vergelijk opties die vergelijkbaar bruikbare resultaten opleveren. Een goedkoper systeem is geen besparing als medewerkers de antwoorden moeten corrigeren of klanten afhaken omdat het systeem traag is.
Kijk verder dan de prijs op de voorgrond:
- API: gebruikskosten, eventuele tools of aanvullende services, herhaalde verzoeken en het werk voor het bouwen en onderhouden van uw applicatie.
- GPU: gehuurde capaciteit, ondersteunende computing en opslag, netwerkkosten, softwareonderhoud en personeels tijd - inclusief back-upcapaciteit indien nodig.
Houd rekening met hoeveel capaciteit ongebruikt blijft. Een stabiele workload kan een gereserveerde GPU rechtvaardigen; incidentele pieken misschien niet. Er is geen enkel verkeersniveau waarbij dedicated hardware voor elke organisatie goedkoper wordt.
Drie alledaagse voorbeelden
Dit zijn illustratieve situaties, geen klantverhalen of beloofde resultaten.
1. Een klantenservice-assistent met onvoorspelbare vraag. Begin met het evalueren van een API als een beschikbaar model goed antwoordt en aan uw gegevensvereisten voldoet. Controleer of het systeem drukke perioden zonder lange wachttijden aankan.
2. Elke nacht documenten sorteren. Een kleine, voorspelbare taak gebruikt een model dat geschikt is voor uw bedrijf en kan wachten tot de ochtend. Gedeelde GPU-capaciteit kan passen, mits deze voldoende geheugen heeft en op tijd klaar is.
3. Een AI-service die de hele dag wordt gebruikt. Uw eigen model verwerkt een stabiele stroom verzoeken en gebruikers verwachten snelle antwoorden. Test dedicated capaciteit, maar bevestig de verbetering en de gebruikskosten voordat u zich vastlegt.
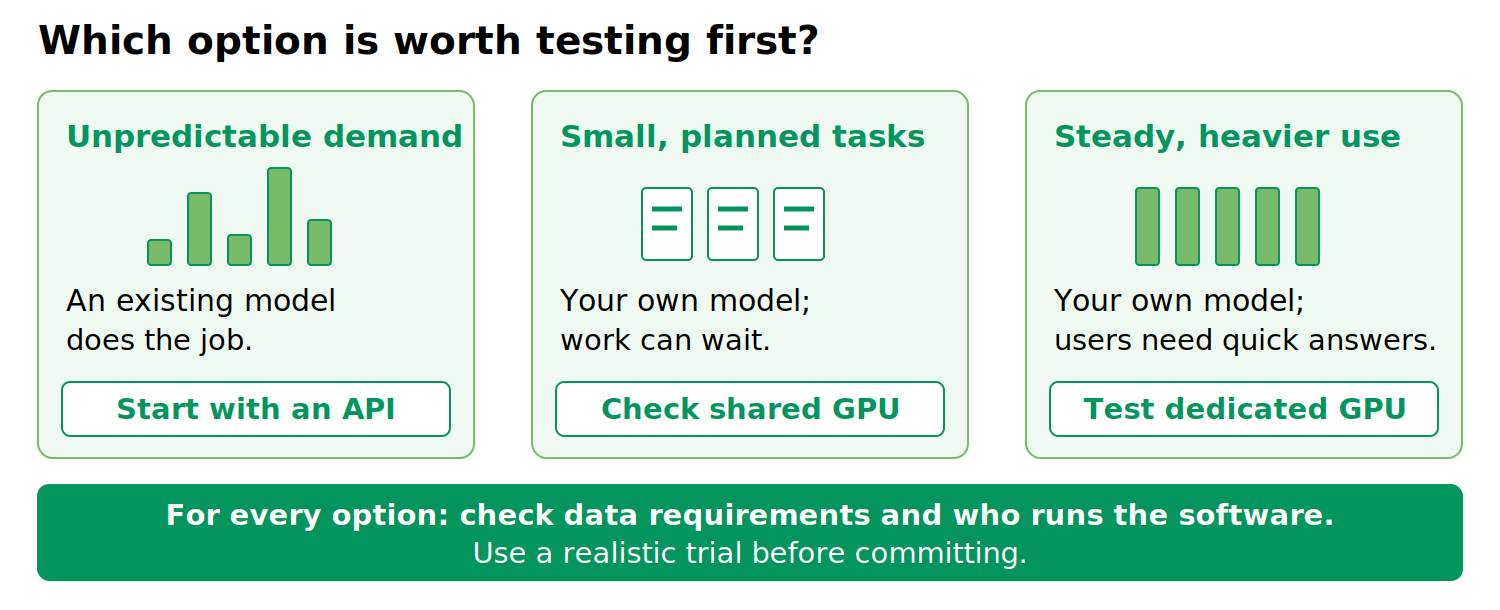
Afbeelding 2. Dit zijn uitgangspunten voor een proef, geen vaste regels. Gegevensvereisten en softwareverantwoordelijkheden zijn in elk geval belangrijk.
Vijf vragen voordat u kiest
Wat moet de AI goed kunnen?
Definieer bruikbare resultaten en acceptabele wachttijden.
Hoe druk zal het zijn?
Houd rekening met pieken, rustige perioden en meerdere gebruikers die tegelijk binnenkomen.
Wie houdt het draaiende?
Spreek de verantwoordelijkheid af voor updates, beveiliging, monitoring en herstel.
Waar gaan de gegevens naartoe?
Controleer verwerking, logs, opslag, bewaartermijnen en back-upproviders. Alleen een toegangspunt in de EU bewijst niet dat elk onderdeel van de service in de EU blijft; controleer ook de contracten.
Wat laat een realistische proef zien?
Vergelijk antwoordkwaliteit, wachttijden en de totale kosten voor het uitvoeren van de taak.
Bespreek uw AI-workload met CloudSigma
Het platform van CloudSigma beschrijft GPU passthrough - directe GPU-toegang voor een virtuele machine - en GPU-slices. De configuratie en het deelgedrag van een slice moeten voor de geselecteerde implementatie worden bevestigd. Beschikbare opties hangen af van de locatie, hardware en serviceovereenkomst. Bevestig wie de AI-software uitvoert voordat u kiest.
CloudSigma AI Mission Control is een aparte toegangs- en toezichtlaag voor ondersteunde beheerde AI-services en geselecteerde directe verbindingen met providers. CloudSigma AI Mission Control biedt een toegangs- en toezichtlaag voor ondersteunde beheerde AI-services en geselecteerde directe verbindingen met providers. Het ondersteunt beleidsregels voor toegang tot modellen, leveranciers en regio's en houdt het gebruik per project bij. Het verbinden van GPU-capaciteit die eigendom is van de klant, is een afzonderlijk proces voor begeleide onboarding, met beoordeling van architectuur, model-serving, beveiliging en beheer - geen automatische selfservice-instelling.
Klaar om uw AI-implementatieopties te evalueren? Neem contact op met CloudSigma over uw workload, verwachte vraag, modelvereisten en behoeften op het gebied van gegevenslocatie. Samen kunt u geschikte opties identificeren en de volgende evaluatiestappen afspreken.
Comments
No comments yet. Be the first.