ИИ-ассистенту, который изредка отвечает на вопросы клиентов, нужно одно, а сервису, обрабатывающему запросы целый день, — другое. Правильный выбор начинается с задачи, ожидаемого спроса и того, кто будет заниматься технологией, а не с самого мощного GPU.
GPU — это мощный чип, используемый для выполнения множества задач ИИ. Модель ИИ — это программное обеспечение, которое выполняет эти задачи. API — это соединение, позволяющее вашему приложению использовать ИИ-сервис, не запуская модель самостоятельно.
Что вы на самом деле выбираете?
В случае управляемого AI API вы получаете доступ к готовому сервису. В случае общих или выделенных GPU вы арендуете вычислительные мощности и, возможно, должны самостоятельно управлять программным обеспечением ИИ.
API-сервис может работать на общем или выделенном оборудовании. Ключевые вопросы: кто эксплуатирует сервис и какая мощность нужна вашей нагрузке.
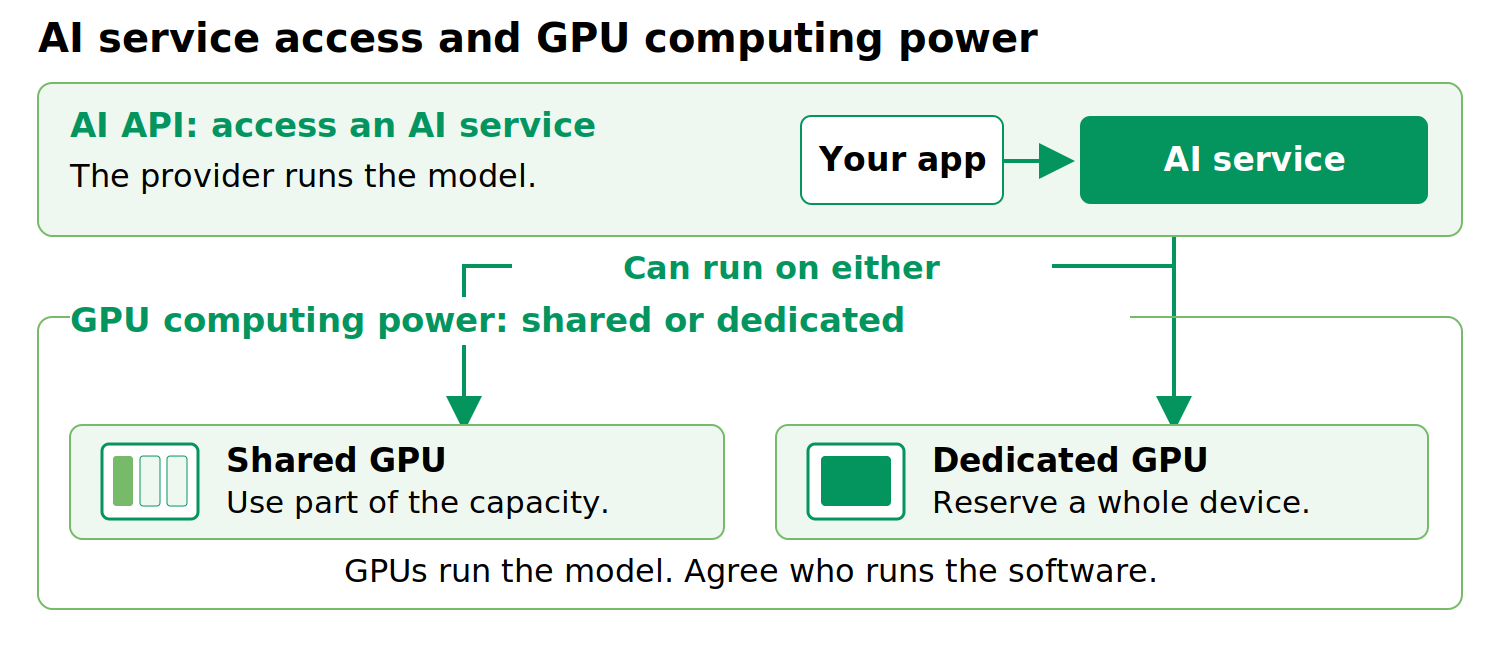
Рисунок 1. Два разных решения: ИИ-сервис, который вы используете, и мощности GPU под ним.
Три способа начать
Вариант 1: использовать ИИ как сервис
Управляемый API позволяет вашей команде подключить приложение к поддерживаемой модели. Модель запускает провайдер; за приложение, права доступа и проверку того, достаточно ли хороши ответы, отвечаете вы.
Это может подойти при неопределённом или неравномерном спросе. Прежде чем принимать обязательства, проверьте лимиты использования, время отклика в периоды пиковой нагрузки и что произойдёт, если провайдер изменит модель. Также узнайте, куда направляются запросы, кто имеет к ним доступ и как долго хранятся данные.
Вариант 2: использовать общие мощности GPU
Сервисы с общими GPU могут распределять ресурсы по-разному, в том числе с помощью аппаратного разделения или разделения времени. Эти подходы дают разный уровень изоляции и предсказуемости производительности. Спросите провайдера, какие ресурсы выделяются под вашу нагрузку и как другие пользователи могут влиять на производительность.
Совместное использование устроено по-разному. Одни сервисы предоставляют аппаратно изолированную часть; другие делят время обработки. Эти варианты не обеспечивают одинаковую защиту или производительность. В документации NVIDIA эти подходы различаются.
Уточните, сколько памяти и вычислительной мощности вы получаете, могут ли другие клиенты влиять на вашу работу и кто поддерживает программное обеспечение ИИ. Одного слова «общий» недостаточно для ответа.
Вариант 3: зарезервировать GPU для вашей команды
Выделенный GPU резервирует для вашей работы весь чип, хотя не обязательно весь сервер. Его стоит рассмотреть при стабильном спросе, более крупных моделях или приложениях, которым нужна специально настроенная среда ИИ.
Если эти услуги не включены, вам всё равно понадобится специалист, который будет устанавливать, обновлять, мониторить и восстанавливать программное обеспечение. Выделенный GPU не обязательно быстрее, безопаснее или соответствует требованиям законодательства. Тестируйте сервис целиком, включая поведение при сбое.
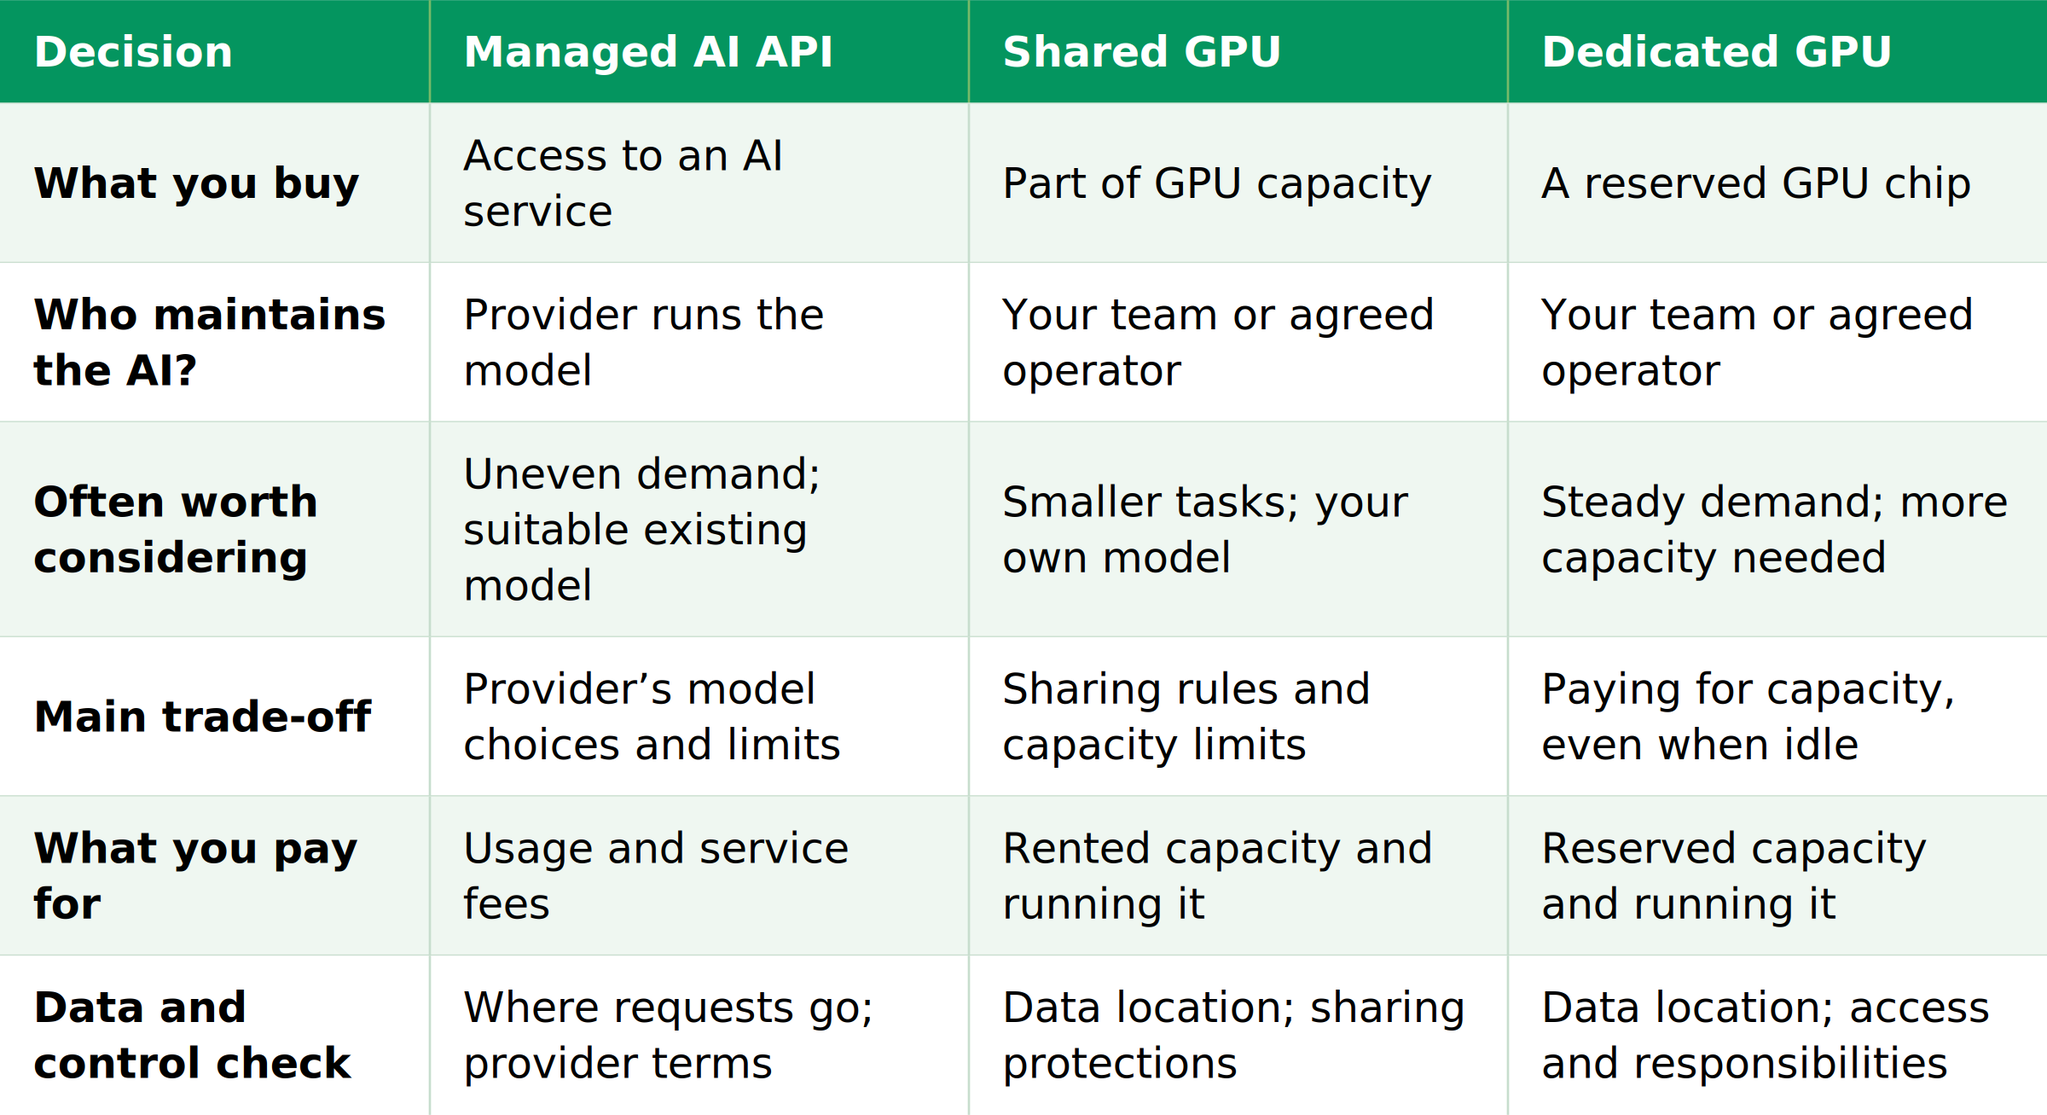
Сравнение вариантов с первого взгляда
Для вариантов с GPU ниже предполагается, что ваша команда сама запускает программное обеспечение ИИ, если вы не приобретаете отдельный управляемый сервис.
Проверьте, что на самом деле нужно для задачи
Начинайте с полезных ответов, а не с технических характеристик. Попробуйте реальные задачи и определите, какое качество приемлемо, как долго люди могут ждать и сколько человек может одновременно пользоваться сервисом.
Важна и память. Модель, которая помещается на GPU для одного короткого запроса, может потребовать больше памяти для длинных документов или нескольких одновременных пользователей. Попросите вашу техническую команду или провайдера проверить рабочую нагрузку целиком.
Время тоже меняет решение. Ночная обработка может ждать в очереди; клиент, ожидающий ответа в реальном времени, обычно не может. Тестируйте периоды пиковой нагрузки, а не только спокойную демонстрацию.
Для адаптации или обучения модели могут понадобиться другие ресурсы, чем для простого использования. Прежде чем арендовать мощности для этой цели, проверьте осуществимость, совместимость программного обеспечения и лицензии на модели.
Сравните полную стоимость
Сравнивайте варианты, дающие одинаково полезные результаты. Более дешёвая система не экономит средства, если сотрудникам приходится исправлять её ответы или клиенты отказываются от неё из-за медленной работы.
Смотрите не только на заявленную цену:
- API: плата за использование, любые инструменты или дополнительные услуги, повторные запросы и работа по созданию и поддержке вашего приложения.
- GPU: арендованные мощности, сопутствующие вычисления и хранилище, плата за сеть, обслуживание программного обеспечения и время сотрудников, включая резервные мощности при необходимости.
Учитывайте, какая часть мощности простаивает. Стабильная нагрузка может оправдать зарезервированный GPU; редкие всплески — нет. Не существует единого уровня трафика, при котором выделенное оборудование становится дешевле для всех организаций.
Три повседневных примера
Это иллюстративные ситуации, а не истории клиентов и не обещанные результаты.
1. Помощник для поддержки клиентов с непредсказуемым спросом. Начните с оценки API, если доступная модель хорошо отвечает и соответствует вашим требованиям к данным. Проверьте, справляется ли она с пиковыми периодами без долгого ожидания.
2. Ночная сортировка документов. Небольшая предсказуемая задача использует модель, подходящую вашему бизнесу, и может подождать до утра. Общие мощности GPU могут подойти, если памяти достаточно и обработка завершается вовремя.
3. ИИ-сервис, используемый в течение всего дня. Ваша собственная модель обрабатывает стабильный поток запросов, а пользователи ожидают быстрых ответов. Протестируйте выделенные мощности, но перед принятием обязательств подтвердите улучшение и эксплуатационные расходы.
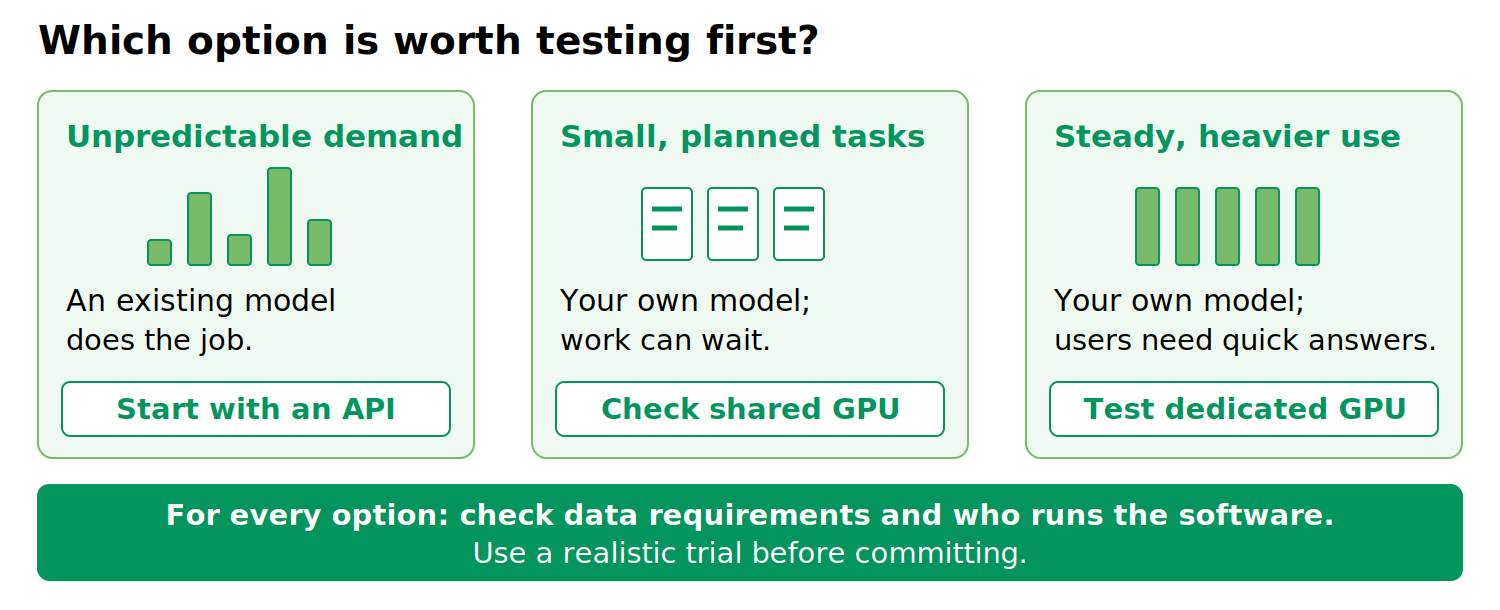
Рисунок 2. Это отправные точки для пилота, а не жёсткие правила. Требования к данным и распределение ответственности за программное обеспечение важны в любом случае.
Пять вопросов перед выбором
Что ИИ должен делать хорошо?
Определите полезные результаты и приемлемое время ожидания.
Насколько высокой будет нагрузка?
Учтите пики, спокойные периоды и одновременный приход нескольких пользователей.
Кто будет поддерживать работу?
Договоритесь об ответственности за обновления, безопасность, мониторинг и восстановление.
Куда попадут данные?
Проверьте обработку, журналы, хранение, сроки хранения и провайдеров резервного копирования. Одна лишь точка доступа в ЕС не доказывает, что каждая часть сервиса остаётся в ЕС; проверьте также договоры.
Что показывает реалистичный пилот?
Сравните качество ответов, время ожидания и полную стоимость выполнения задачи.
Обсудите вашу ИИ-нагрузку с CloudSigma
Платформа CloudSigma предлагает GPU passthrough — прямой доступ виртуальной машины к GPU — и GPU-слайсы. Конфигурацию и поведение при совместном использовании слайса необходимо подтвердить для выбранного развёртывания. Доступные варианты зависят от локации, оборудования и условий предоставления услуги. Перед выбором уточните, кто запускает программное обеспечение ИИ.
CloudSigma AI Mission Control — это отдельный уровень доступа и контроля для поддерживаемых управляемых ИИ-сервисов и выбранных прямых подключений к провайдерам. CloudSigma AI Mission Control обеспечивает уровень доступа и контроля для поддерживаемых управляемых ИИ-сервисов и выбранных прямых подключений к провайдерам. Он поддерживает политики, регулирующие доступ к моделям, поставщикам и регионам, и отслеживает использование по проектам. Подключение принадлежащих клиенту мощностей GPU — это отдельный процесс сопровождаемого подключения с анализом архитектуры, обслуживания моделей, безопасности и эксплуатации, а не автоматическая самостоятельная настройка.
Готовы оценить варианты развёртывания ИИ? Свяжитесь с CloudSigma, чтобы обсудить вашу нагрузку, ожидаемый спрос, требования к моделям и потребности в расположении данных. Вместе вы сможете определить подходящие варианты и согласовать следующие шаги оценки.
Comments
No comments yet. Be the first.