Un assistant d’IA qui répond occasionnellement aux questions des clients n’a pas les mêmes besoins qu’un service qui traite des demandes toute la journée. Le bon choix commence par la tâche, la demande prévue et la personne qui prendra en charge la technologie, et non par le GPU le plus puissant.
Un GPU est une puce puissante utilisée pour exécuter de nombreuses tâches d’IA. Un modèle d’IA est le logiciel qui effectue ces tâches. Une API est une connexion qui permet à votre application d’utiliser un service d’IA sans exécuter elle-même le modèle.
Que choisissez-vous réellement ?
Avec une API d’IA gérée, vous accédez à un service prêt à l’emploi. Avec des GPU partagés ou dédiés, vous louez une capacité de calcul et devrez peut-être gérer vous-même le logiciel d’IA.
Un service d’API peut fonctionner sur du matériel partagé ou dédié. Les questions essentielles sont de savoir qui exploite le service et quelle capacité votre charge de travail nécessite.
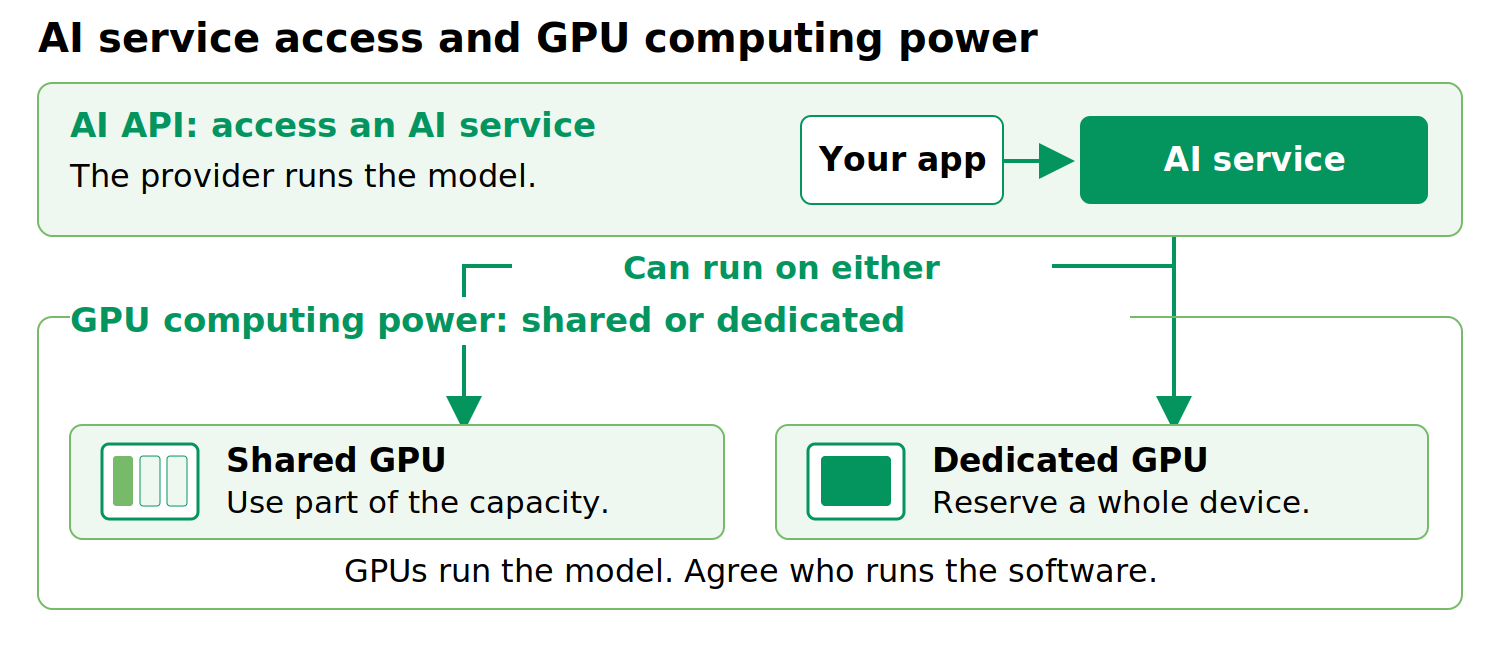
Figure 1. Deux décisions différentes : le service d’IA que vous utilisez et la capacité GPU sous-jacente.
Trois façons de commencer
Option 1 : utiliser l’IA en tant que service
Une API gérée permet à votre équipe de connecter une application à un modèle pris en charge. Le fournisseur exécute le modèle ; vous restez responsable de l’application, des autorisations d’accès et de la vérification de la qualité des réponses.
Cette solution peut convenir à une demande incertaine ou irrégulière. Avant de vous engager, vérifiez les limites d’utilisation, les temps de réponse pendant les périodes de forte activité et ce qui se passe lorsque le fournisseur modifie un modèle. Demandez également où les requêtes sont envoyées, qui peut y accéder et combien de temps les données sont conservées.
Option 2 : partager une capacité GPU
Les services GPU partagés peuvent allouer les ressources de différentes manières, notamment par partitionnement matériel ou partage du temps d’utilisation. Ces approches offrent des niveaux différents d’isolation et de prévisibilité des performances. Demandez au fournisseur quelles ressources sont allouées à votre charge de travail et comment les autres utilisateurs peuvent affecter les performances.
Le partage peut fonctionner de différentes façons. Certains services fournissent une portion séparée au niveau matériel ; d’autres partagent le temps de traitement. Ces solutions n’offrent pas le même niveau de protection ni les mêmes performances. La documentation de NVIDIA distingue ces approches.
Demandez quelle quantité de mémoire et de capacité de traitement vous recevez, si d’autres clients peuvent affecter votre activité et qui assure la maintenance du logiciel d’IA. Le terme « partagé » ne suffit pas à répondre à ces questions.
Option 3 : réserver un GPU pour votre équipe
Un GPU dédié réserve une puce entière à votre activité, mais pas nécessairement l’ensemble du serveur. Cette solution mérite d’être envisagée en cas de demande constante, de modèles plus volumineux ou d’applications nécessitant une configuration d’IA spécifique.
Vous devez toujours disposer d’une personne pour installer, mettre à jour, surveiller et restaurer le logiciel, sauf si ces services sont inclus. Un GPU dédié n’est pas automatiquement plus rapide, plus sécurisé ou conforme aux exigences légales. Testez le service complet, y compris ce qui se passe en cas de défaillance.
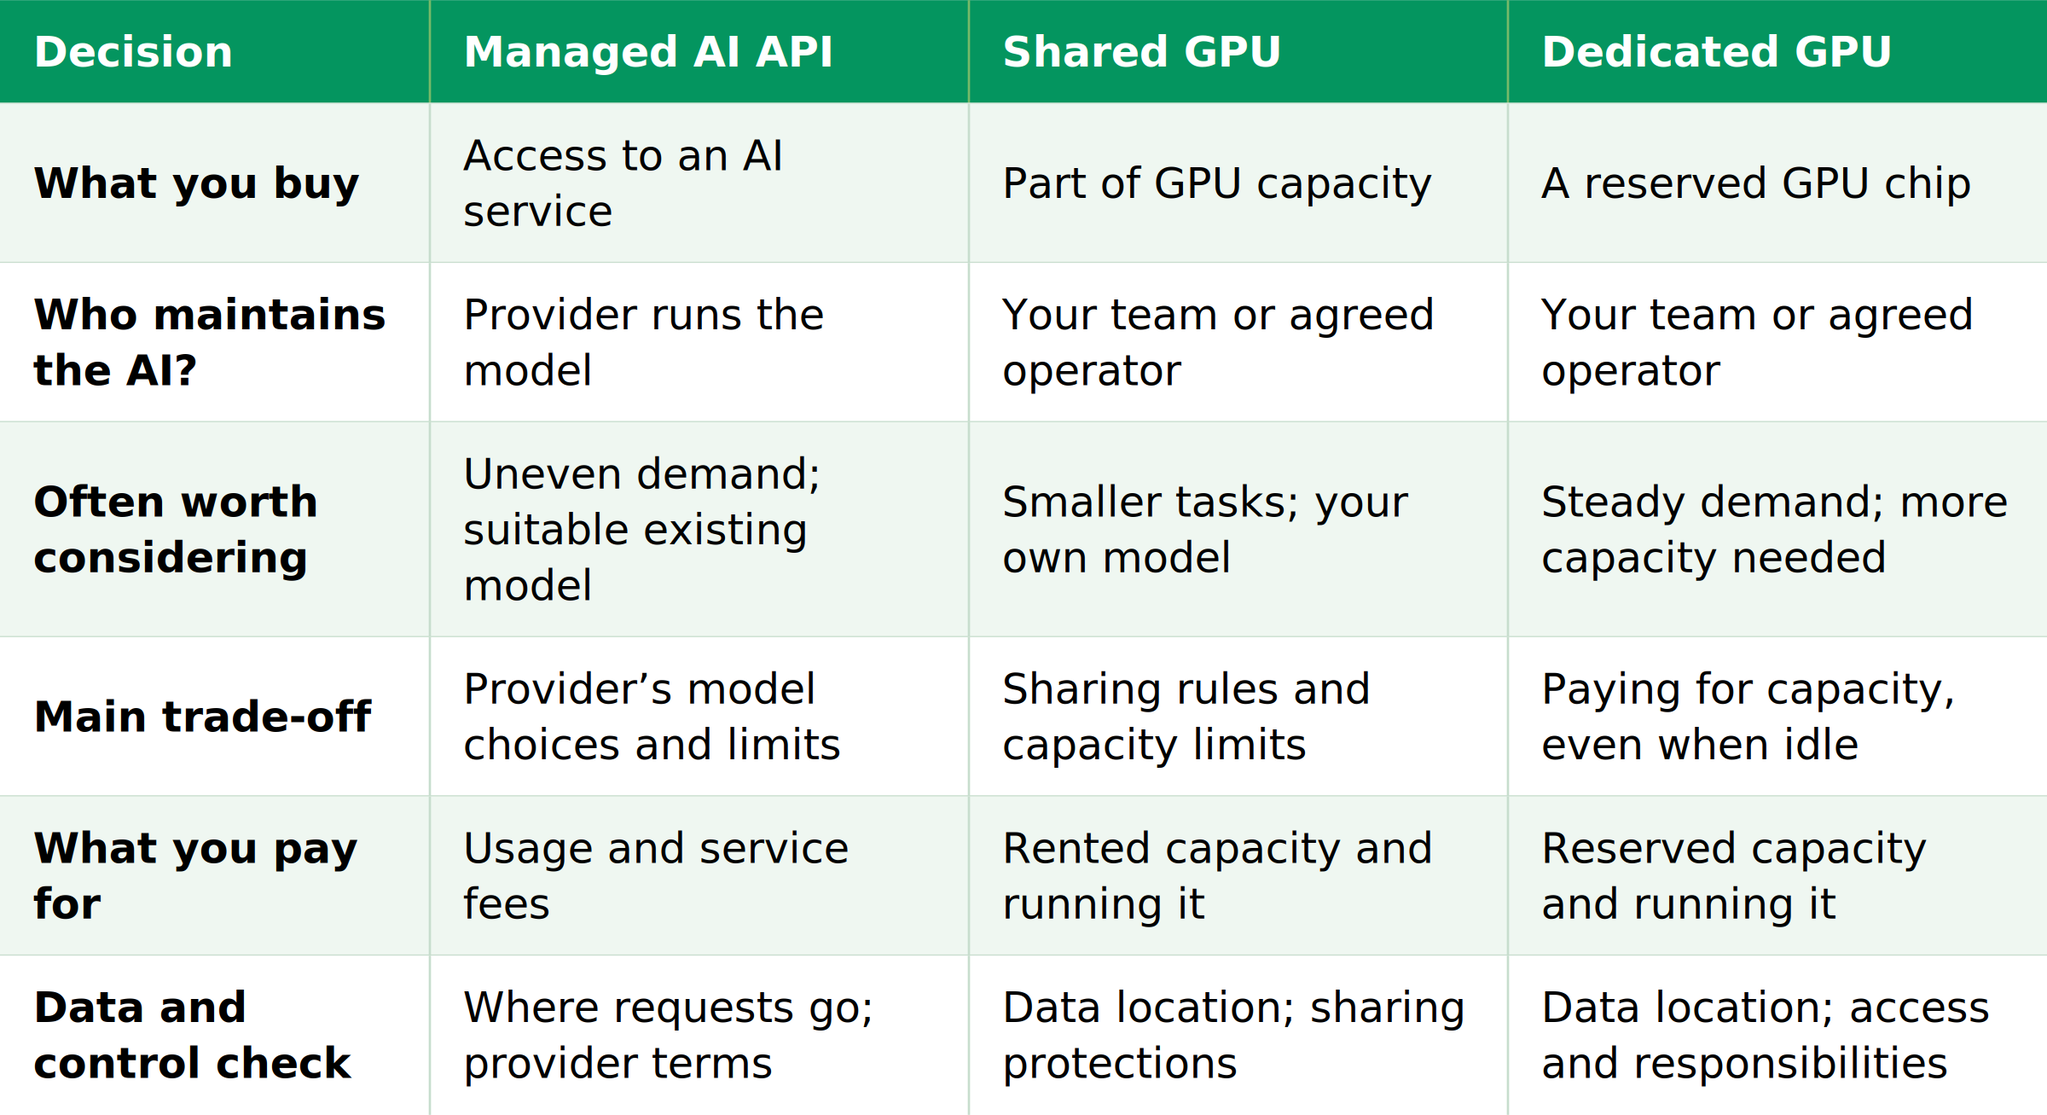
Comparez les options en un coup d’œil
Pour les options GPU ci-dessous, partez du principe que votre équipe exécute le logiciel d’IA, sauf si vous achetez un service géré distinct.
Vérifiez les besoins réels de la tâche
Commencez par les réponses utiles, et non par les caractéristiques techniques. Testez des tâches réelles et déterminez le niveau de qualité acceptable, le temps d’attente que les utilisateurs peuvent tolérer et le nombre de personnes susceptibles d’utiliser le service simultanément.
La mémoire est également importante. Un modèle qui tient sur un GPU pour une courte requête peut nécessiter davantage de mémoire pour de longs documents ou plusieurs utilisateurs simultanés. Demandez à votre équipe technique ou à votre fournisseur d’examiner la charge de travail complète.
Le facteur temps modifie la décision. Un traitement de nuit peut attendre dans une file d’attente ; un client qui attend une réponse en direct, généralement non. Testez les périodes de forte activité ainsi qu’une démonstration dans des conditions calmes.
L’adaptation ou l’entraînement d’un modèle peut nécessiter des ressources différentes de celles requises pour sa simple utilisation. Vérifiez la faisabilité, la compatibilité logicielle et les licences du modèle avant de louer une capacité à cette fin.
Comparez le coût total
Comparez les options qui produisent des résultats d’une utilité comparable. Un système moins cher ne constitue pas une économie si le personnel doit corriger ses réponses ou si les clients l’abandonnent parce qu’il est lent.
Allez au-delà du prix affiché :
- API : frais d’utilisation, outils ou services supplémentaires, requêtes répétées et travail nécessaire pour créer et maintenir votre application.
- GPU : capacité louée, ressources de calcul et de stockage complémentaires, frais réseau, maintenance logicielle et temps du personnel, y compris une capacité de secours si nécessaire.
Tenez compte de la capacité inutilisée. Une charge de travail constante peut justifier un GPU réservé ; des pics occasionnels, pas forcément. Il n’existe pas de niveau de trafic unique à partir duquel le matériel dédié devient moins cher pour toutes les organisations.
Trois exemples du quotidien
Il s’agit de situations illustratives, et non de témoignages clients ni de résultats garantis.
1. Un assistant d’aide aux clients avec une demande imprévisible. Commencez par évaluer une API si un modèle disponible fournit de bonnes réponses et répond à vos exigences en matière de données. Vérifiez s’il peut gérer les périodes de forte activité sans longs délais d’attente.
2. Le tri de documents chaque nuit. Une tâche réduite et prévisible utilise un modèle adapté à votre activité et peut attendre le matin. Une capacité GPU partagée peut convenir, à condition de disposer de suffisamment de mémoire et de terminer à temps.
3. Un service d’IA utilisé toute la journée. Votre propre modèle traite un flux constant de requêtes et les utilisateurs attendent des réponses rapides. Testez une capacité dédiée, mais confirmez l’amélioration et les coûts d’exploitation avant de vous engager.
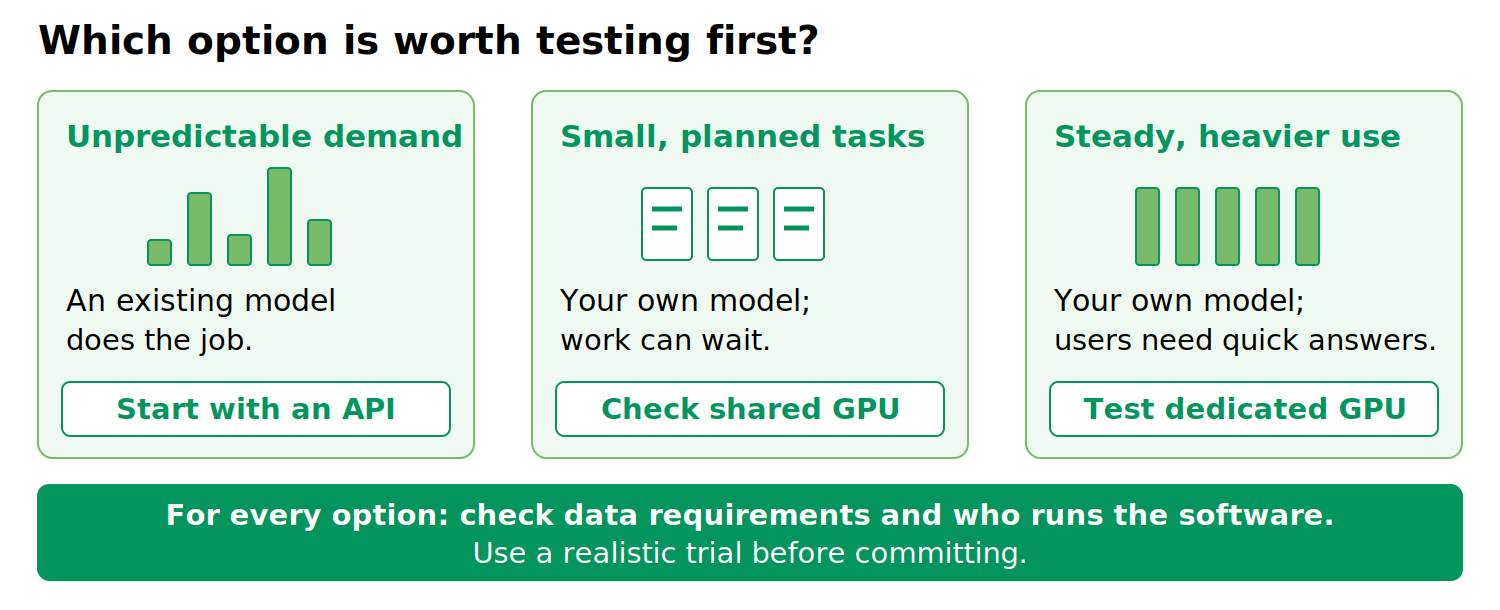
Figure 2. Il s’agit de points de départ pour un essai, et non de règles fixes. Les exigences en matière de données et les responsabilités logicielles sont importantes dans tous les cas.
Cinq questions à vous poser avant de choisir
Que doit bien faire l’IA ?
Définissez les résultats utiles et les temps d’attente acceptables.
Quel sera le niveau d’activité ?
Incluez les pics, les périodes creuses et l’arrivée simultanée de plusieurs utilisateurs.
Qui assurera son fonctionnement ?
Définissez les responsabilités concernant les mises à jour, la sécurité, la surveillance et la restauration.
Où les données seront-elles envoyées ?
Vérifiez le traitement, les journaux, le stockage, la conservation et les fournisseurs de sauvegarde. Un point d’accès situé dans l’UE ne prouve pas à lui seul que chaque partie du service reste dans l’UE ; vérifiez également les contrats.
Que montre un essai réaliste ?
Comparez la qualité des réponses, les temps d’attente et le coût total de réalisation de la tâche.
Discutez de votre charge de travail d’IA avec CloudSigma
La plateforme de CloudSigma décrit le passthrough GPU, c’est-à-dire l’accès direct à un GPU pour une machine virtuelle, ainsi que les tranches de GPU. La configuration et le comportement en matière de partage d’une tranche doivent être confirmés pour le déploiement sélectionné. Les options disponibles dépendent de l’emplacement, du matériel et de l’accord de service. Confirmez qui exécute le logiciel d’IA avant de faire votre choix.
CloudSigma AI Mission Control est une couche distincte d’accès et de supervision pour les services d’IA gérés pris en charge et certaines connexions directes à des fournisseurs. CloudSigma AI Mission Control fournit une couche d’accès et de supervision pour les services d’IA gérés pris en charge et certaines connexions directes à des fournisseurs. Elle prend en charge les politiques régissant l’accès aux modèles, aux fournisseurs et aux régions, et suit l’utilisation par projet. La connexion d’une capacité GPU appartenant au client est un processus distinct d’intégration assistée, avec examen de l’architecture, du service de modèles, de la sécurité et de l’exploitation, et non une configuration automatique en libre-service.
Prêt à évaluer vos options de déploiement d’IA ? Contactez CloudSigma pour discuter de votre charge de travail, de la demande prévue, de vos exigences concernant le modèle et de vos besoins en matière d’emplacement des données. Ensemble, vous pourrez identifier les options adaptées et convenir des prochaines étapes de l’évaluation.
Comments
No comments yet. Be the first.