Ein KI-Assistent, der gelegentlich Kundenfragen beantwortet, hat andere Anforderungen als ein Dienst, der den ganzen Tag Anfragen verarbeitet. Die richtige Wahl beginnt mit der Aufgabe, dem erwarteten Bedarf und der Frage, wer sich um die Technologie kümmert – nicht mit der größten GPU.
Eine GPU ist ein leistungsstarker Chip, der für viele KI-Aufgaben verwendet wird. Ein KI-Modell ist die Software, die diese Aufgaben ausführt. Eine API ist eine Verbindung, über die Ihre Anwendung einen KI-Dienst nutzen kann, ohne das Modell selbst auszuführen.
Was wählen Sie eigentlich?
Bei einer verwalteten KI-API greifen Sie auf einen sofort einsatzbereiten Dienst zu. Bei gemeinsam genutzten oder dedizierten GPUs mieten Sie Rechenkapazität und müssen die KI-Software möglicherweise selbst verwalten.
Ein API-Dienst kann auf gemeinsam genutzter oder dedizierter Hardware ausgeführt werden. Die entscheidenden Fragen sind, wer den Dienst betreibt und welche Kapazität Ihre Arbeitslast benötigt.
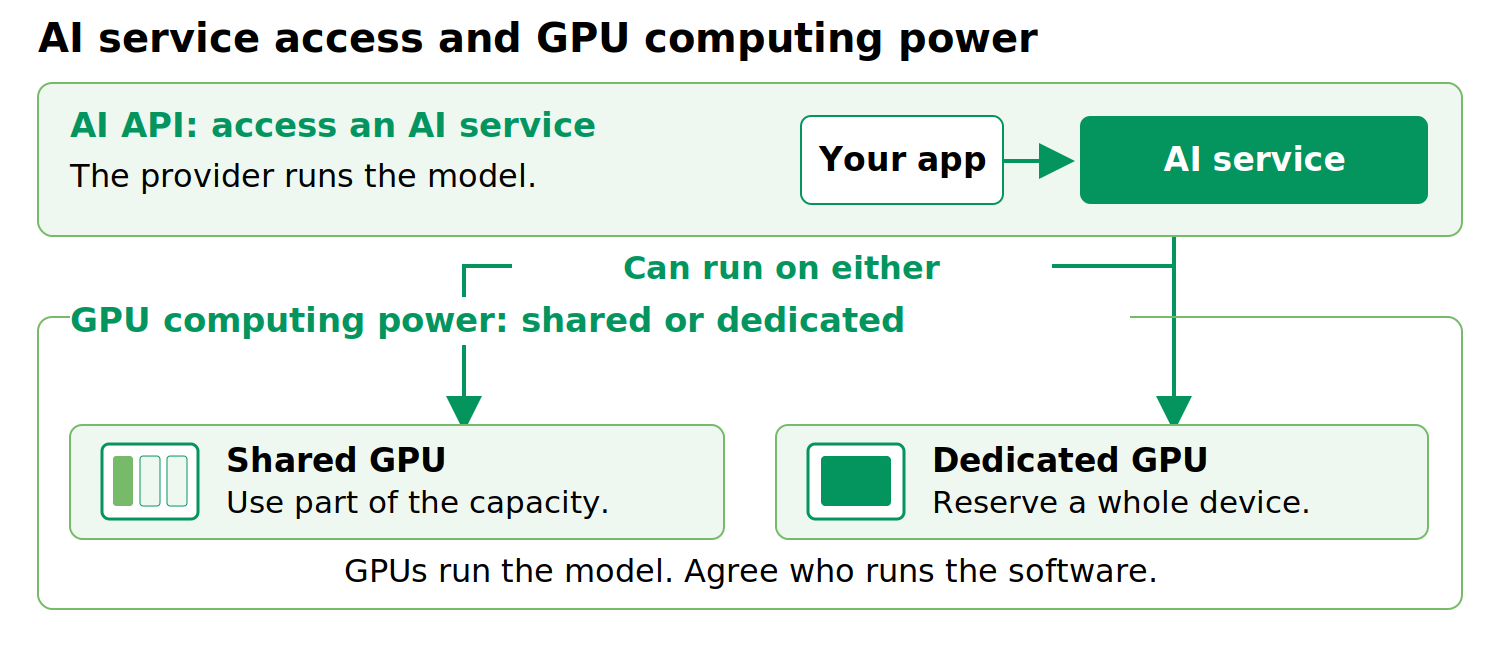
Abbildung 1. Zwei unterschiedliche Entscheidungen: der von Ihnen genutzte KI-Dienst und die darunterliegende GPU-Kapazität.
Drei Möglichkeiten für den Einstieg
Option 1: KI als Dienst nutzen
Mit einer verwalteten API kann Ihr Team eine Anwendung mit einem unterstützten Modell verbinden. Der Anbieter führt das Modell aus; Sie bleiben für die Anwendung, Zugriffsberechtigungen und die Prüfung verantwortlich, ob die Antworten gut genug sind.
Dies kann bei unsicherem oder ungleichmäßigem Bedarf geeignet sein. Prüfen Sie vor einer Entscheidung die Nutzungsgrenzen, Antwortzeiten in Spitzenzeiten und was passiert, wenn der Anbieter ein Modell ändert. Fragen Sie außerdem, wohin Anfragen gesendet werden, wer darauf zugreifen kann und wie lange die Daten gespeichert werden.
Option 2: GPU-Kapazität teilen
Gemeinsam genutzte GPU-Dienste können Ressourcen auf unterschiedliche Weise zuweisen, unter anderem durch Hardware-Partitionierung oder zeitliche Aufteilung. Diese Ansätze bieten unterschiedliche Grade an Isolation und Vorhersagbarkeit der Leistung. Fragen Sie den Anbieter, welche Ressourcen Ihrer Arbeitslast zugewiesen werden und wie andere Nutzer die Leistung beeinflussen können.
Die gemeinsame Nutzung funktioniert auf unterschiedliche Weise. Einige Dienste stellen einen hardwareseitig getrennten Anteil bereit; andere teilen die Verarbeitungszeit. Diese Varianten bieten nicht denselben Schutz oder dieselbe Leistung. Die Dokumentation von NVIDIA unterscheidet zwischen diesen Ansätzen.
Fragen Sie, wie viel Speicher und Rechenkapazität Sie erhalten, ob andere Kunden Ihre Arbeit beeinflussen können und wer die KI-Software wartet. „Gemeinsam genutzt“ allein beantwortet diese Fragen nicht.
Option 3: Eine GPU für Ihr Team reservieren
Eine dedizierte GPU reserviert einen vollständigen Chip für Ihre Arbeit, jedoch nicht unbedingt den gesamten Server. Dies ist für einen konstanten Bedarf, größere Modelle oder Anwendungen mit einer speziell konfigurierten KI-Umgebung interessant.
Sie benötigen weiterhin jemanden, der die Software installiert, aktualisiert, überwacht und im Fehlerfall wiederherstellt, sofern diese Leistungen nicht enthalten sind. Eine dedizierte GPU ist nicht automatisch schneller, sicherer oder rechtlich konform. Testen Sie den vollständigen Dienst, einschließlich des Verhaltens bei einem Ausfall.
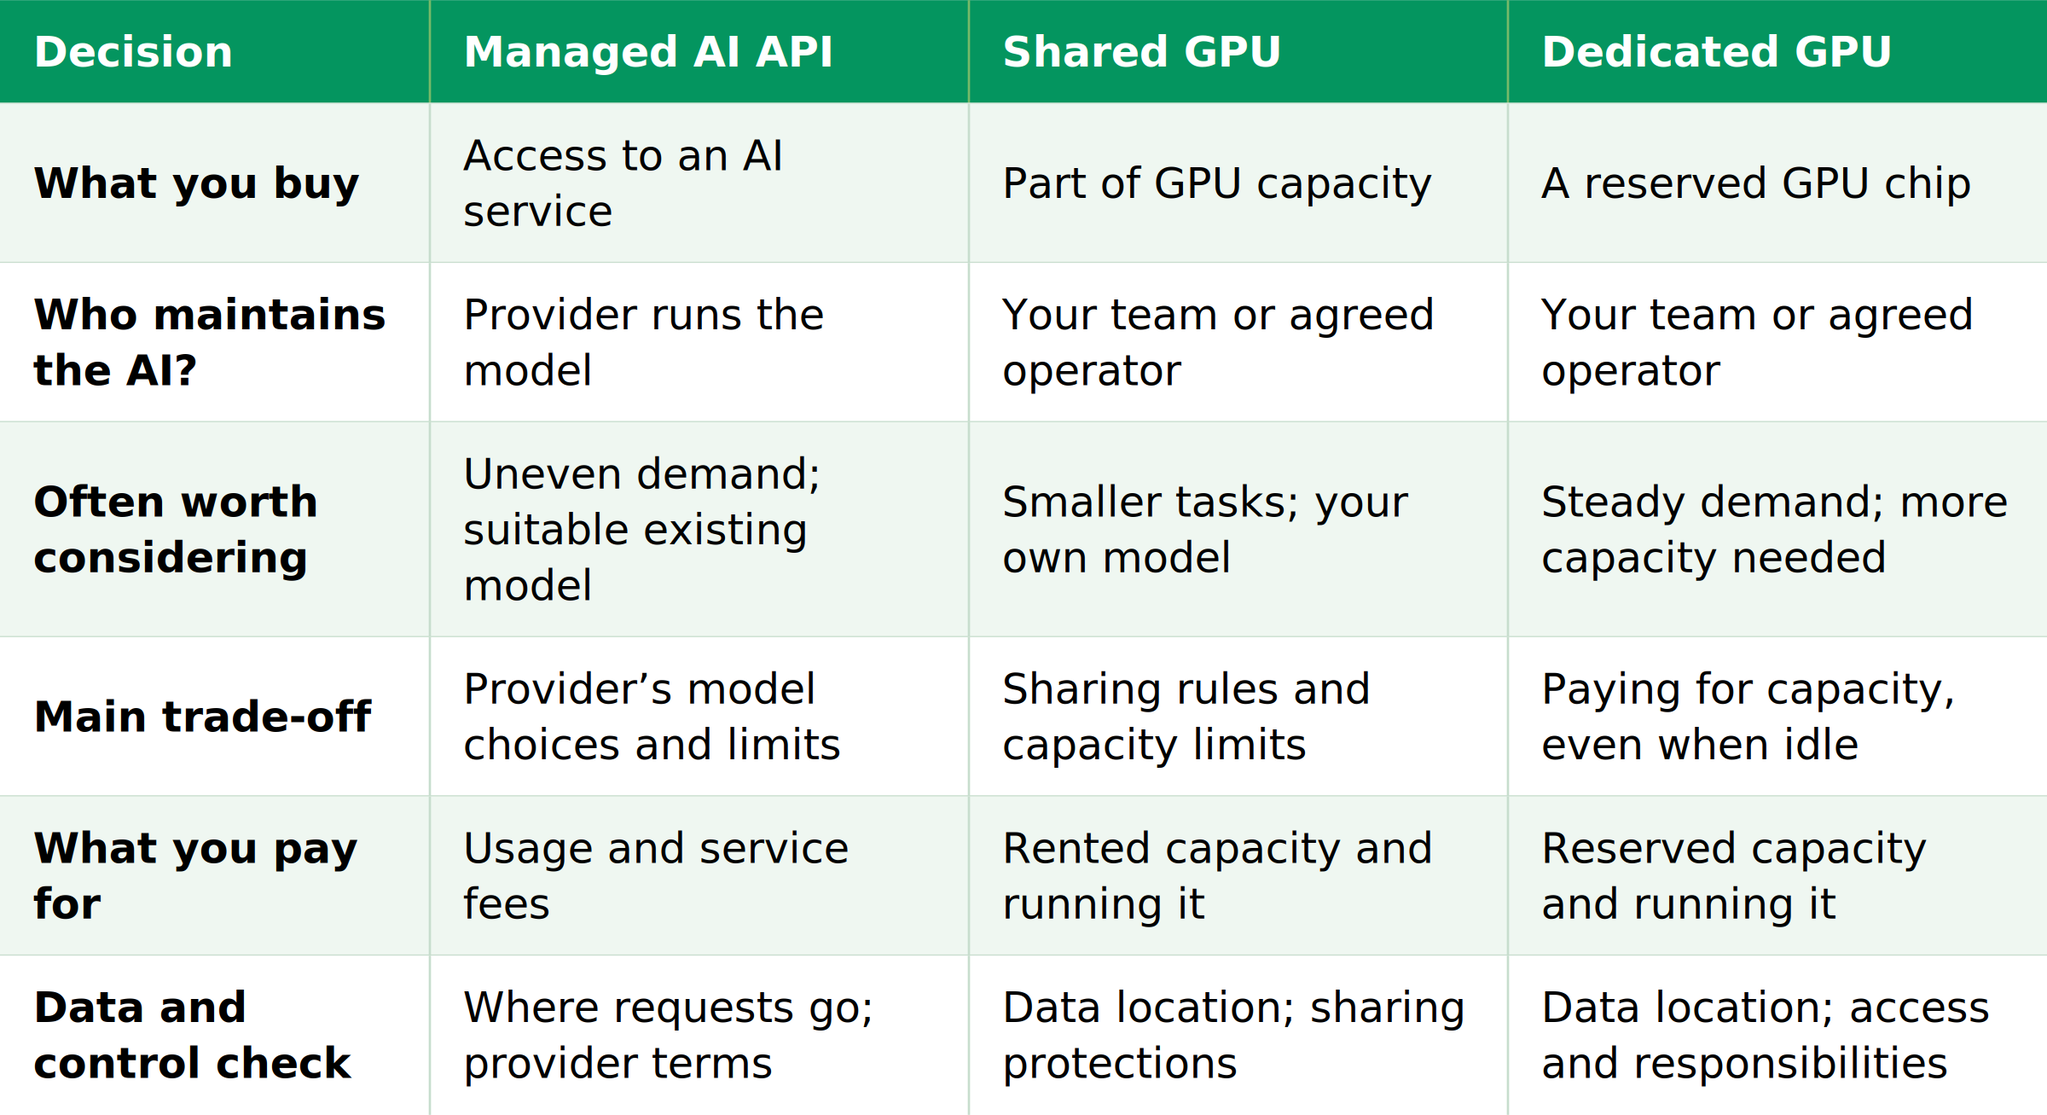
Vergleich der Optionen auf einen Blick
Für die folgenden GPU-Optionen wird vorausgesetzt, dass Ihr Team die KI-Software ausführt, sofern Sie keinen separaten verwalteten Dienst erwerben.
Prüfen Sie, was die Aufgabe wirklich erfordert
Beginnen Sie mit nützlichen Antworten, nicht mit technischen Spezifikationen. Testen Sie reale Aufgaben und entscheiden Sie, welche Qualität akzeptabel ist, wie lange Nutzer warten können und wie viele Personen den Dienst gleichzeitig verwenden könnten.
Auch der Speicher ist wichtig. Ein Modell, das für eine kurze Anfrage auf eine GPU passt, benötigt bei langen Dokumenten oder mehreren gleichzeitigen Nutzern möglicherweise mehr Speicher. Bitten Sie Ihr technisches Team oder Ihren Anbieter, die vollständige Arbeitslast zu prüfen.
Der zeitliche Ablauf beeinflusst die Entscheidung. Die Verarbeitung über Nacht kann in einer Warteschlange warten; ein Kunde, der auf eine sofortige Antwort wartet, kann dies normalerweise nicht. Testen Sie sowohl Spitzenzeiten als auch eine ruhige Demonstration.
Die Anpassung oder das Training eines Modells kann andere Ressourcen erfordern als dessen bloße Nutzung. Prüfen Sie Machbarkeit, Softwarekompatibilität und Modelllizenzen, bevor Sie dafür Kapazität mieten.
Vergleichen Sie die Gesamtkosten
Vergleichen Sie Optionen, die ähnlich nützliche Ergebnisse liefern. Ein günstigeres System ist keine Ersparnis, wenn Mitarbeitende seine Antworten korrigieren müssen oder Kunden es wegen langsamer Reaktionszeiten abbrechen.
Betrachten Sie mehr als nur den angegebenen Preis:
- API: Nutzungsgebühren, zusätzliche Tools oder Dienste, wiederholte Anfragen sowie der Aufwand für die Entwicklung und Wartung Ihrer Anwendung.
- GPU: gemietete Kapazität, unterstützende Rechenleistung und Speicher, Netzwerkgebühren, Softwarewartung und Arbeitszeit – einschließlich zusätzlicher Backup-Kapazität, falls erforderlich.
Berücksichtigen Sie, wie viel Kapazität ungenutzt bleibt. Eine konstante Arbeitslast kann eine reservierte GPU rechtfertigen; gelegentliche Spitzen möglicherweise nicht. Es gibt keinen einzelnen Auslastungsgrad, ab dem dedizierte Hardware für jede Organisation günstiger wird.
Drei Beispiele aus dem Alltag
Dies sind illustrative Situationen, keine Kundengeschichten oder zugesicherten Ergebnisse.
1. Ein Kundenhilfe-Assistent mit unvorhersehbarem Bedarf. Beginnen Sie mit der Bewertung einer API, wenn ein verfügbares Modell gute Antworten liefert und Ihre Datenanforderungen erfüllt. Prüfen Sie, ob es Spitzenzeiten ohne lange Wartezeiten bewältigen kann.
2. Dokumente, die jede Nacht sortiert werden. Eine kleine, planbare Aufgabe verwendet ein für Ihr Unternehmen geeignetes Modell und kann bis zum Morgen warten. Eine gemeinsam genutzte GPU-Kapazität kann passen, sofern sie über genügend Speicher verfügt und rechtzeitig fertig wird.
3. Ein KI-Dienst, der den ganzen Tag genutzt wird. Ihr eigenes Modell verarbeitet kontinuierlich Anfragen, und die Nutzer erwarten schnelle Antworten. Testen Sie dedizierte Kapazität, bestätigen Sie jedoch vor einer Entscheidung die Verbesserung und die Betriebskosten.
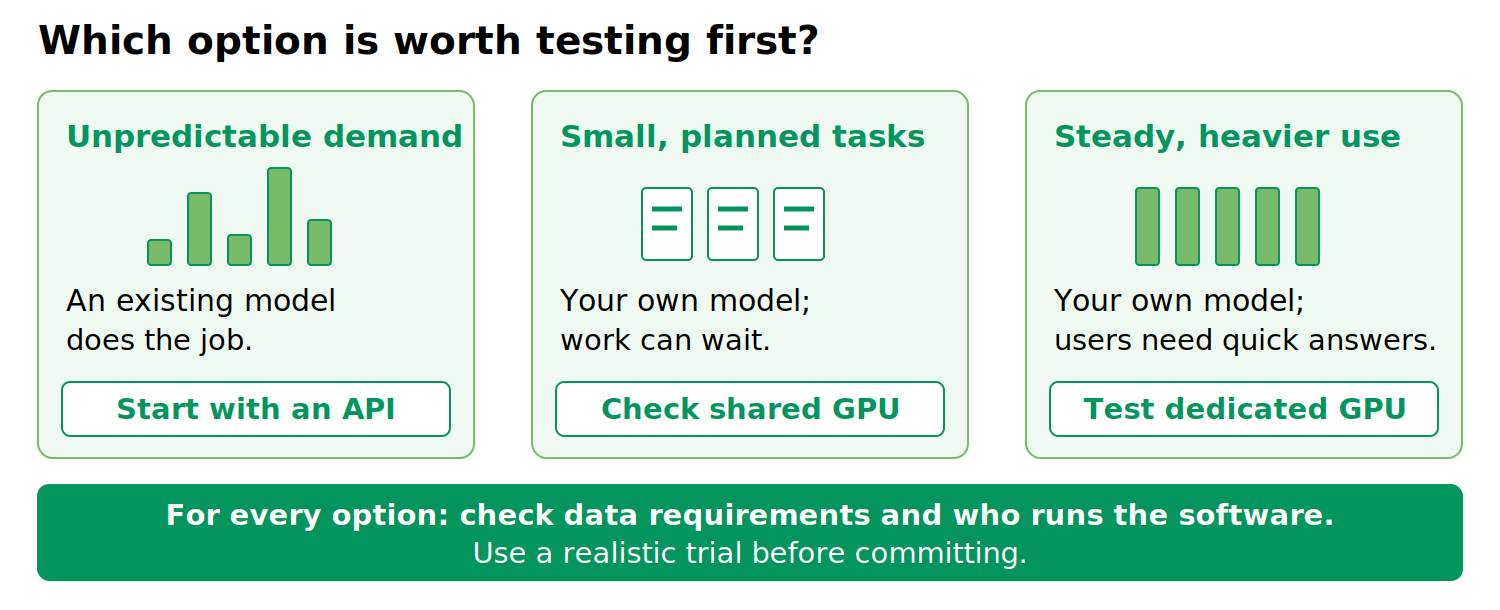
Abbildung 2. Dies sind Ausgangspunkte für einen Test, keine festen Regeln. Datenanforderungen und Verantwortlichkeiten für die Software sind in jedem Fall wichtig.
Fünf Fragen vor Ihrer Entscheidung
Was muss die KI gut leisten?
Definieren Sie nützliche Ergebnisse und akzeptable Wartezeiten.
Wie stark wird sie ausgelastet sein?
Berücksichtigen Sie Spitzenzeiten, ruhige Phasen und mehrere gleichzeitig eintreffende Nutzer.
Wer hält sie am Laufen?
Legen Sie die Verantwortung für Updates, Sicherheit, Überwachung und Wiederherstellung fest.
Wohin werden die Daten übertragen?
Prüfen Sie Verarbeitung, Protokolle, Speicherung, Aufbewahrung und Backup-Anbieter. Ein EU-Zugangspunkt allein beweist nicht, dass jeder Teil des Dienstes in der EU verbleibt; prüfen Sie auch die Verträge.
Was zeigt ein realistischer Test?
Vergleichen Sie Antwortqualität, Wartezeiten und die vollständigen Kosten für die Erledigung der Aufgabe.
Besprechen Sie Ihre KI-Arbeitslast mit CloudSigma
Die CloudSigma-Plattform beschreibt GPU-Passthrough – den direkten GPU-Zugriff für eine virtuelle Maschine – und GPU-Slices. Die Konfiguration und das Verhalten bei der gemeinsamen Nutzung eines Slices müssen für die ausgewählte Bereitstellung bestätigt werden. Die verfügbaren Optionen hängen vom Standort, der Hardware und der Servicevereinbarung ab. Klären Sie vor der Entscheidung, wer die KI-Software ausführt.
CloudSigma AI Mission Control ist eine separate Zugriffs- und Überwachungsebene für unterstützte verwaltete KI-Dienste und ausgewählte direkte Verbindungen zu Anbietern. CloudSigma AI Mission Control bietet eine Zugriffs- und Überwachungsebene für unterstützte verwaltete KI-Dienste und ausgewählte direkte Verbindungen zu Anbietern. Es unterstützt Richtlinien für den Zugriff auf Modelle, Anbieter und Regionen und erfasst die Nutzung nach Projekt. Die Verbindung kundeneigener GPU-Kapazität ist ein separater Prozess für das unterstützte Onboarding mit Architektur-, Modellbereitstellungs-, Sicherheits- und Betriebsprüfung – keine automatische Self-Service-Einrichtung.
Bereit, Ihre Optionen für die KI-Bereitstellung zu bewerten? Sprechen Sie mit CloudSigma über Ihre Arbeitslast, den erwarteten Bedarf, Modellanforderungen und Anforderungen an den Datenstandort. Gemeinsam können Sie geeignete Optionen ermitteln und die nächsten Schritte für die Bewertung vereinbaren.
Comments
No comments yet. Be the first.