偶尔回答客户问题的 AI 助手,与全天处理请求的服务,需求各不相同。正确的选择应从任务、预期需求量以及由谁负责技术运维出发,而不是一味追求最强大的 GPU。
GPU 是一种用于执行多种 AI 任务的高性能芯片。AI 模型是执行这些任务的软件。API 则是一种连接方式,让您的应用无需自行运行模型即可使用 AI 服务。
您实际上在选择什么?
使用托管式 AI API,您获得的是开箱即用的服务。选择共享或独享 GPU,您租用的是计算资源,并且可能需要自行管理 AI 软件。
API 服务既可以运行在共享硬件上,也可以运行在独享硬件上。关键问题在于由谁运营服务,以及您的工作负载需要多少资源。
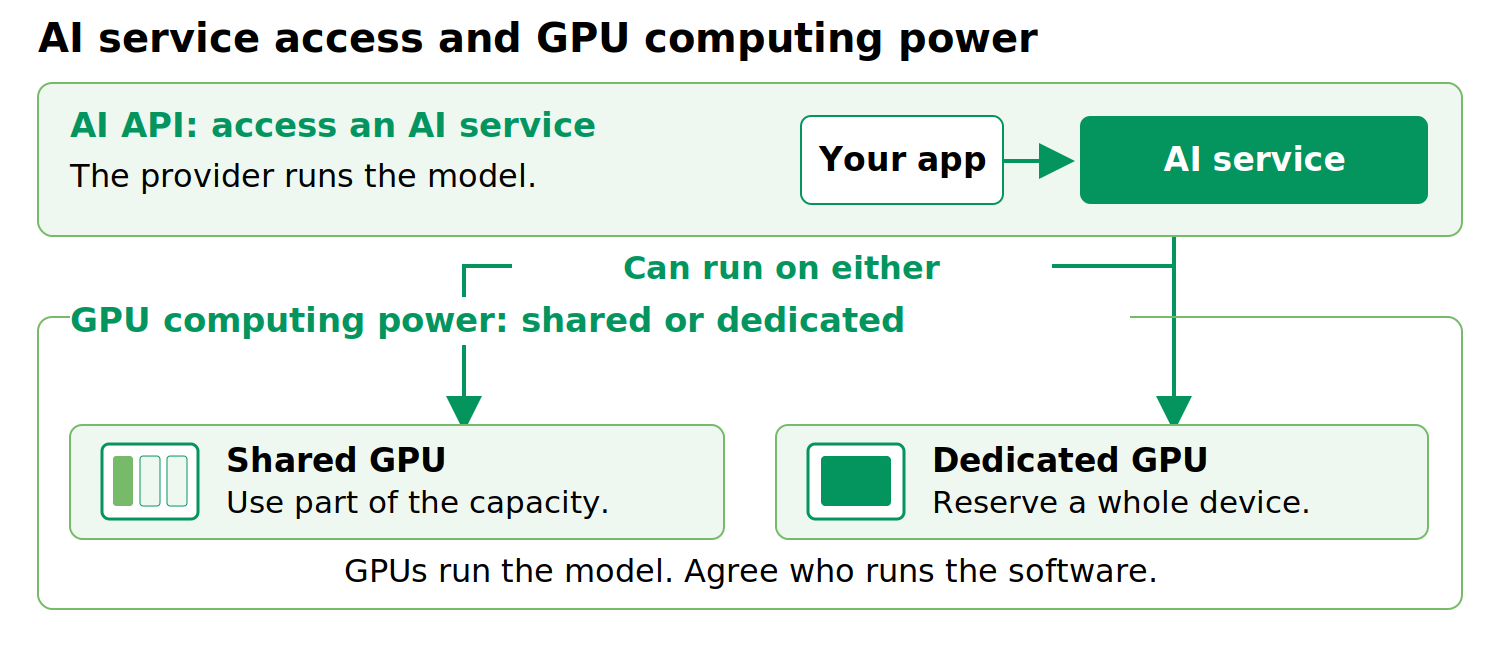
图 1. 两个不同的决策:您使用的 AI 服务,以及支撑该服务的 GPU 资源。
三种入门方式
方案 1:以服务形式使用 AI
托管式 API 让您的团队能够将应用连接到受支持的模型。服务提供商负责运行模型;您仍需负责应用、访问权限,以及检查模型的回答是否达到要求。
这可能适合需求量不确定或波动较大的场景。在决定采用之前,请检查使用限制、高峰时段的响应时间,以及服务提供商更换模型时会产生什么影响。同时还应询问请求会发送到哪里、谁可以访问请求,以及数据会保留多久。
方案 2:共享 GPU 资源
共享 GPU 服务可以通过不同方式分配资源,包括硬件分区或分时共享。这些方式在隔离程度和性能可预测性方面各不相同。请向服务提供商了解,会为您的工作负载分配哪些资源,以及其他用户可能如何影响性能。
共享有不同的实现方式。有些服务提供通过硬件隔离的部分资源;另一些则共享处理时间。这些方式提供的保护和性能并不相同。NVIDIA 的文档区分了这些方式。
请询问您能获得多少显存和处理能力、其他客户是否会影响您的任务,以及由谁维护 AI 软件。仅凭“共享”一词无法得知答案。
方案 3:为您的团队预留 GPU
独享 GPU 会为您的任务预留一整颗芯片,但不一定包含整台服务器。对于需求稳定、模型较大或需要特殊 AI 配置的应用,这种方案值得考虑。
除非服务已包含相关内容,否则您仍需要有人负责软件的安装、更新、监控和故障恢复。独享 GPU 并不必然更快、更安全或符合法律法规要求。请测试完整的服务,包括发生故障时的处理情况。
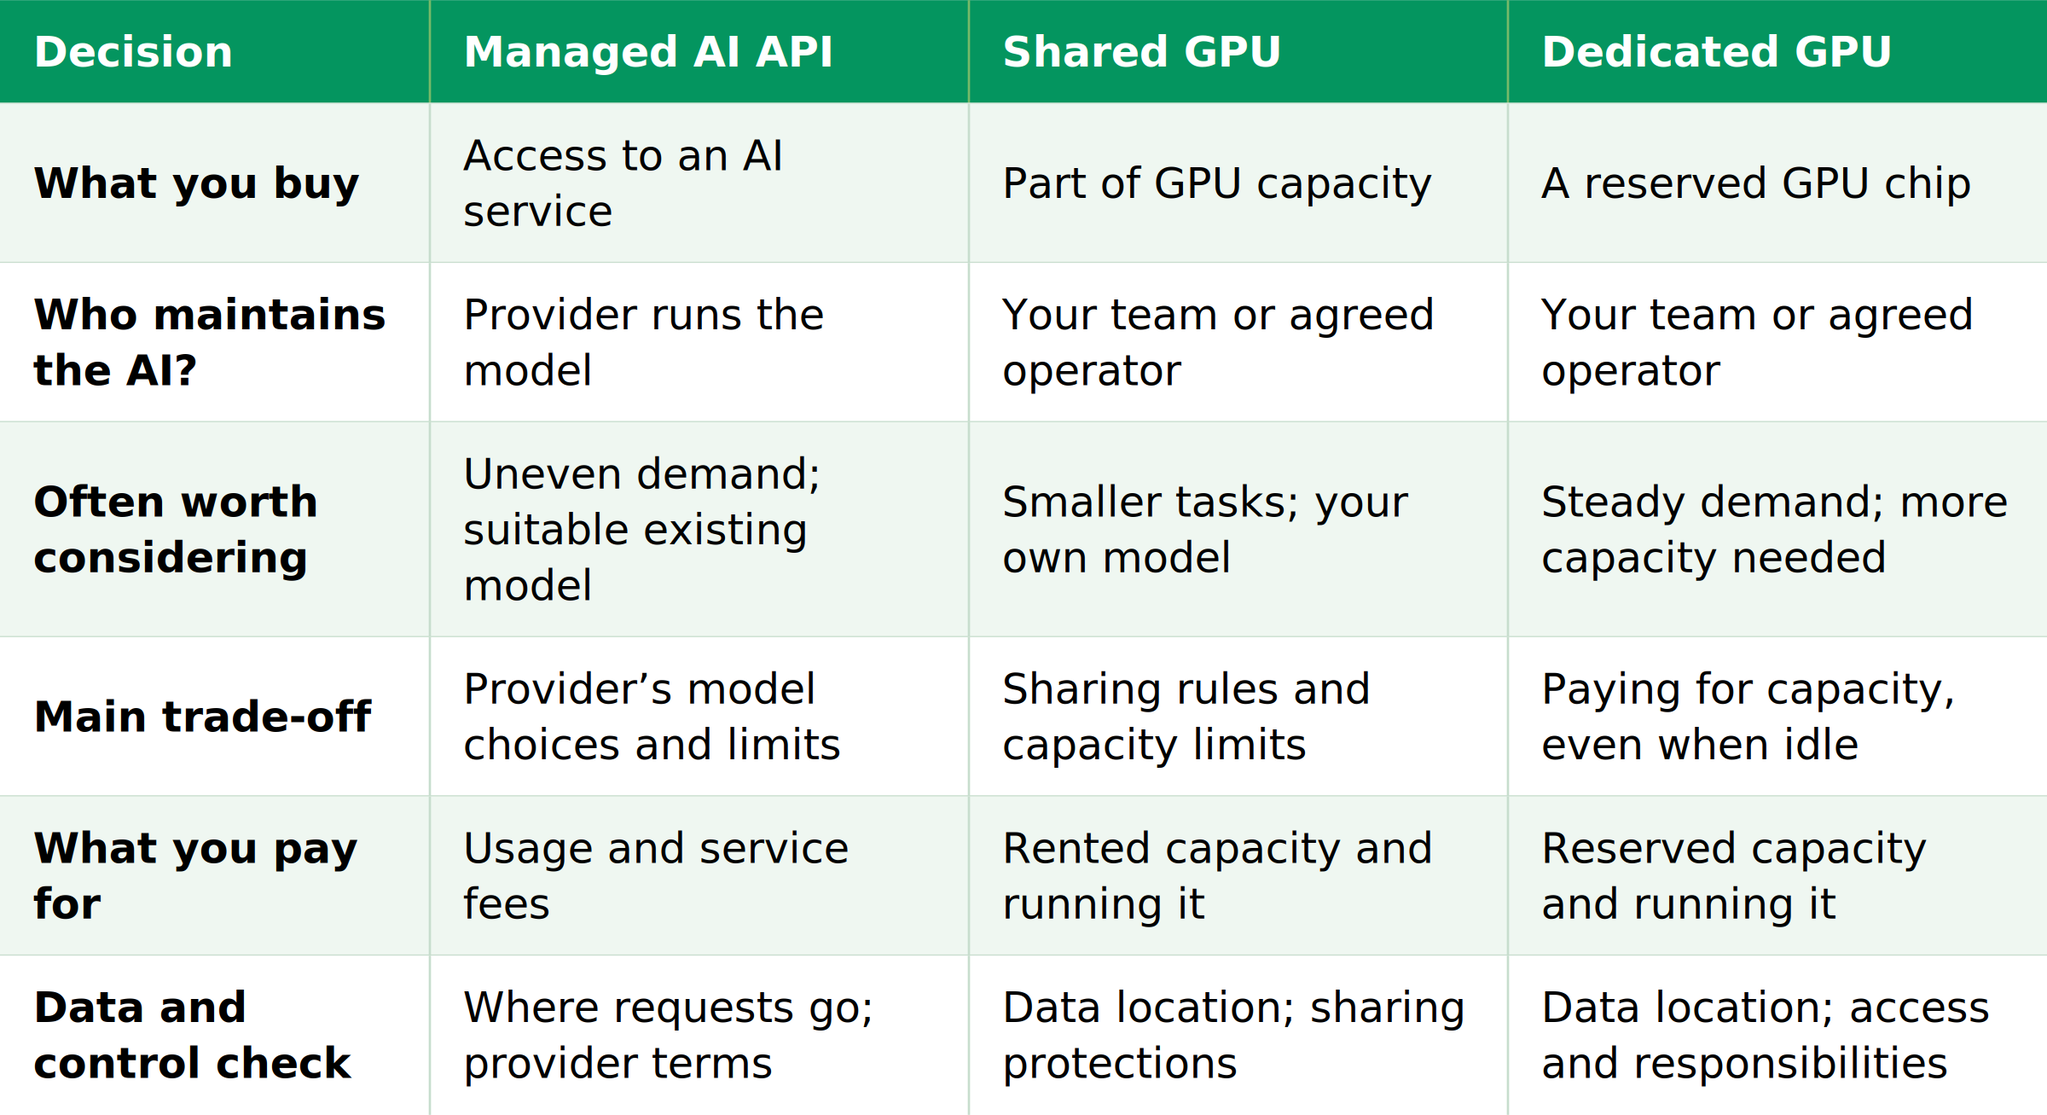
各方案对比速览
对于下方的 GPU 方案,假设由您的团队运行 AI 软件,除非您另行购买托管服务。
确认任务的实际需求
从有用的回答入手,而不是从技术规格入手。尝试真实任务,确定什么样的质量可以接受、用户能等待多久,以及可能有多少人同时使用服务。
显存同样重要。某个模型在处理单个简短请求时可能可以装入一块 GPU,但处理长文档或多个并发用户时,可能需要更多显存。请让您的技术团队或服务提供商检查完整工作负载。
时效要求会影响决策。夜间处理任务可以排队等待,而等待实时回答的客户通常不能。除了在低负载下进行演示,也应测试高峰时段的表现。
调整或训练模型所需的资源,可能与单纯使用模型不同。在为此租用资源之前,请检查可行性、软件兼容性和模型许可证。
比较总成本
应比较能够产生相近实用效果的方案。如果员工必须纠正系统的回答,或者客户因为系统响应缓慢而放弃使用,那么价格更低的系统也无法真正节省成本。
不要只看标价:
- API:使用费用、任何工具或附加服务的费用、重复请求的费用,以及构建和维护应用所需的工作。
- GPU:租用资源、配套计算和存储、网络费用、软件维护和人员时间,还包括必要时的备用资源。
考虑会有多少资源处于闲置状态。稳定的工作负载可能值得预留 GPU;偶发的突发需求则未必。不存在一个适用于所有组织的统一流量门槛,使独享硬件在超过该门槛后就一定更便宜。
三个日常场景示例
以下是示意场景,并非客户案例或效果承诺。
1. 需求不可预测的客户支持助手。如果现有模型能够给出良好回答,并且满足您的数据要求,可以先评估 API。检查它能否在高峰时段处理请求,避免用户长时间等待。
2. 每晚整理文档。这是一项规模小、可预测的任务,使用适合您业务的模型,并且可以等到早晨完成。共享 GPU 资源可能适合,前提是显存充足且能按时完成任务。
3. 全天使用的 AI 服务。您自己的模型持续处理稳定的请求流,用户希望快速得到回答。可以测试独享资源,但在决定采用之前,应确认实际改善效果和运行成本。
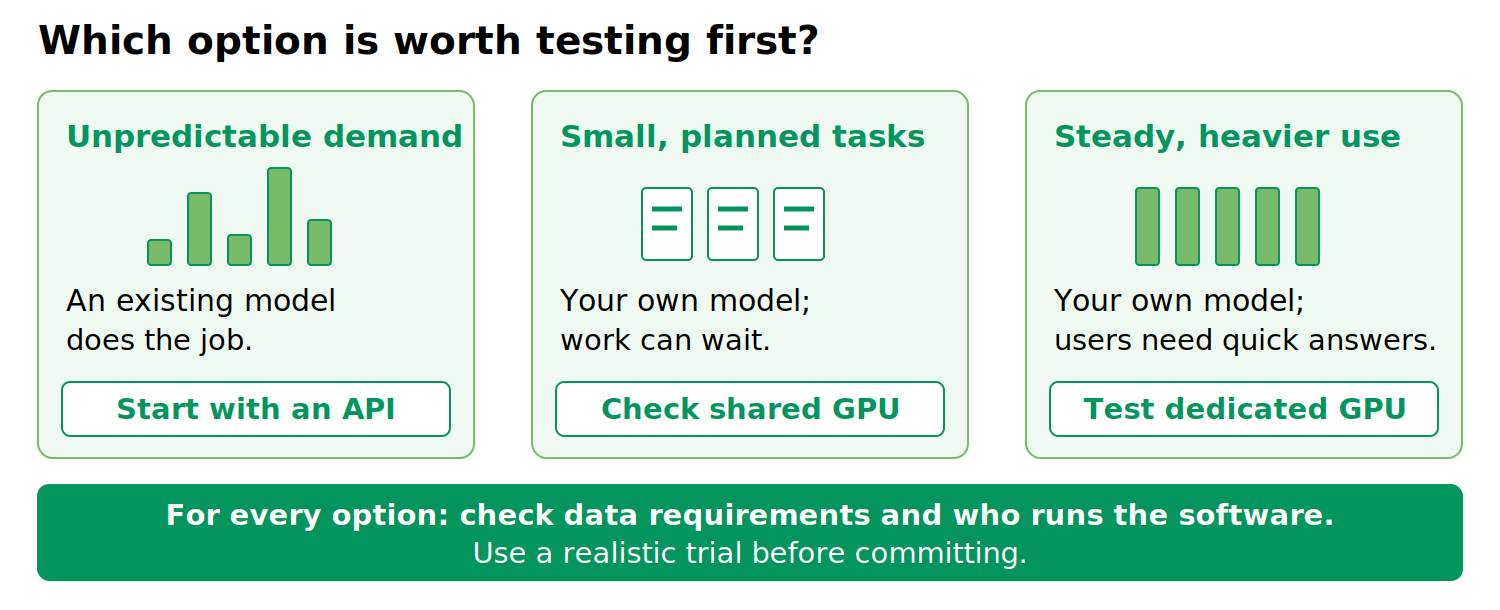
图 2. 这些只是试用的起点,并非固定规则。无论哪种情况,数据要求和软件管理职责都很重要。
选择前要问的五个问题
AI 必须擅长做什么?
明确什么样的结果有用,以及可以接受的等待时间。
使用量会有多大?
将高峰、低谷以及多名用户同时访问的情况都考虑在内。
由谁保障持续运行?
就更新、安全、监控和故障恢复的责任达成一致。
数据会流向哪里?
检查数据处理、日志、存储、保留期限和备份服务提供商。仅有欧盟接入点,并不能证明服务的每个环节都位于欧盟境内;还要检查合同。
贴近实际的试用说明了什么?
比较回答质量、等待时间以及完成任务的总成本。
与 CloudSigma 探讨您的 AI 工作负载
CloudSigma 平台介绍了 GPU 直通,即让虚拟机直接访问 GPU,以及 GPU 切片。对于选定的部署,需要确认切片的配置和共享行为。可用方案取决于地点、硬件和服务安排。选择前,请确认由谁运行 AI 软件。
CloudSigma AI Mission Control 是一个独立的访问与监管层,面向受支持的托管式 AI 服务和选定的服务提供商直连。CloudSigma AI Mission Control 为受支持的托管式 AI 服务和选定的服务提供商直连提供访问与监管层。它支持用于管理模型、供应商和区域访问权限的策略,并按项目跟踪用量。接入客户自有的 GPU 资源需要通过单独的辅助接入流程,其中包括架构、模型服务、安全和运维审查,而非自动化的自助配置。
准备好评估您的 AI 部署方案了吗?联系 CloudSigma,探讨您的工作负载、预期需求量、模型要求和数据存放位置要求。双方可以共同确定合适的方案,并商定后续评估步骤。
Comments
No comments yet. Be the first.