Um assistente de IA que responde a perguntas ocasionais de clientes tem necessidades diferentes de um serviço que processa solicitações durante todo o dia. A escolha certa começa pelo objetivo, pela demanda esperada e por quem cuidará da tecnologia — não pela maior GPU.
Uma GPU é um chip poderoso usado para executar muitas tarefas de IA. Um modelo de IA é o software que realiza essas tarefas. Uma API é uma conexão que permite que sua aplicação use um serviço de IA sem executar o modelo por conta própria.
O que você está realmente escolhendo?
Com uma API de IA gerenciada, você acessa um serviço pronto para uso. Com GPUs compartilhadas ou dedicadas, você aluga capacidade computacional e talvez precise gerenciar o software de IA por conta própria.
Um serviço de API pode ser executado em hardware compartilhado ou dedicado. As principais questões são quem opera o serviço e qual capacidade sua carga de trabalho exige.
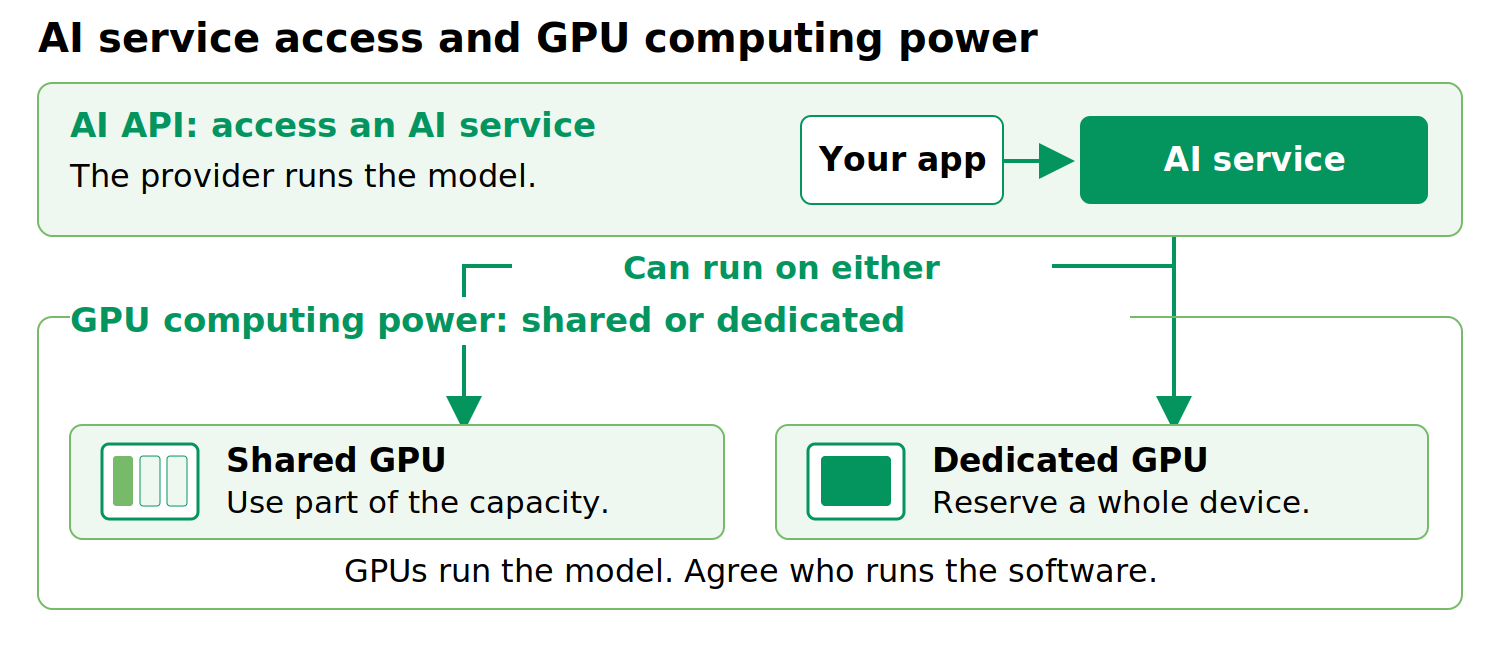
Figura 1. Duas decisões diferentes: o serviço de IA que você usa e a capacidade de GPU por trás dele.
Três maneiras de começar
Opção 1: usar IA como serviço
Uma API gerenciada permite que sua equipe conecte uma aplicação a um modelo compatível. O provedor executa o modelo; você continua responsável pela aplicação, pelas permissões de acesso e por verificar se as respostas são boas o suficiente.
Essa opção pode ser adequada para uma demanda incerta ou irregular. Antes de se comprometer, verifique os limites de uso, os tempos de resposta em períodos de alta demanda e o que acontece quando o provedor altera um modelo. Pergunte também para onde as solicitações são enviadas, quem pode acessá-las e por quanto tempo os dados são mantidos.
Opção 2: compartilhar a capacidade de GPU
Os serviços de GPU compartilhada podem alocar recursos de diferentes maneiras, incluindo particionamento de hardware ou compartilhamento de tempo. Essas abordagens oferecem diferentes níveis de isolamento e previsibilidade de desempenho. Pergunte ao provedor quais recursos são alocados à sua carga de trabalho e como outros usuários podem afetar o desempenho.
O compartilhamento funciona de diferentes formas. Alguns serviços fornecem uma parte separada do hardware; outros compartilham o tempo de processamento. Essas opções não oferecem proteção nem desempenho idênticos. A documentação da NVIDIA diferencia essas abordagens.
Pergunte quanta memória e capacidade de processamento você recebe, se outros clientes podem afetar seu trabalho e quem mantém o software de IA. O termo “compartilhada”, por si só, não responde a essas perguntas.
Opção 3: reservar uma GPU para sua equipe
Uma GPU dedicada reserva um chip inteiro para o seu trabalho, embora não necessariamente o servidor inteiro. Vale considerar essa opção para uma demanda constante, modelos maiores ou aplicações que precisam de uma configuração de IA especialmente ajustada.
Você ainda precisará de alguém para instalar, atualizar, monitorar e recuperar o software, a menos que esses serviços estejam incluídos. Uma GPU dedicada não é automaticamente mais rápida, mais segura ou legalmente compatível. Teste o serviço completo, incluindo o que acontece durante uma falha.
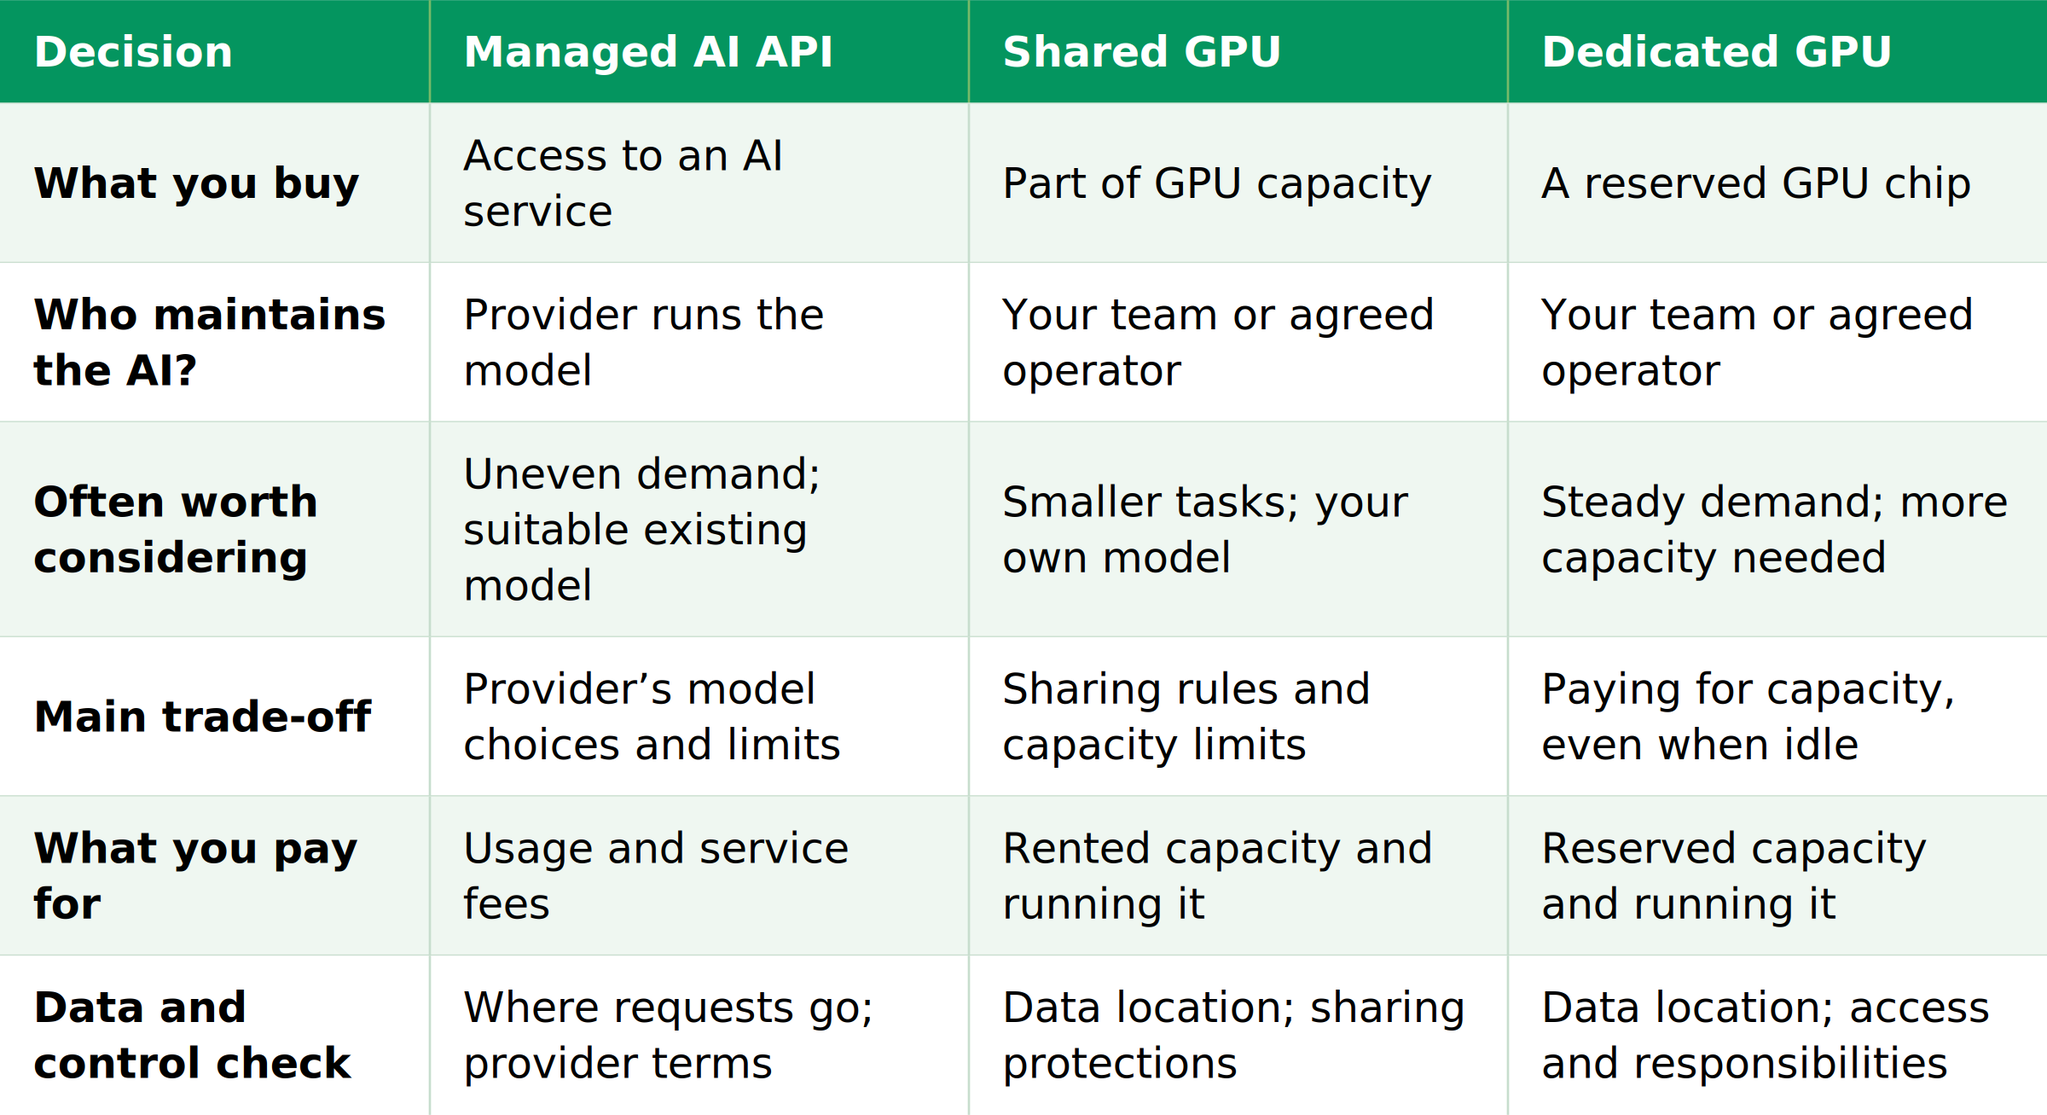
Compare as opções rapidamente
Para as opções de GPU abaixo, suponha que sua equipe execute o software de IA, a menos que você compre um serviço gerenciado separado.
Verifique o que o trabalho realmente exige
Comece pelas respostas úteis, não pelas especificações técnicas. Teste tarefas reais e decida qual qualidade é aceitável, quanto tempo as pessoas podem esperar e quantas pessoas poderão usar o serviço ao mesmo tempo.
A memória também importa. Um modelo que cabe em uma GPU para uma solicitação curta pode precisar de mais memória para documentos longos ou vários usuários simultâneos. Peça à sua equipe técnica ou ao provedor que verifique a carga de trabalho completa.
O tempo altera a decisão. O processamento noturno pode esperar em uma fila; um cliente aguardando uma resposta em tempo real geralmente não pode. Teste períodos de alta demanda, além de uma demonstração em condições tranquilas.
Adaptar ou treinar um modelo pode exigir recursos diferentes dos necessários para simplesmente usá-lo. Verifique a viabilidade, a compatibilidade do software e as licenças do modelo antes de alugar capacidade para esse fim.
Compare o custo total
Compare opções que entreguem resultados igualmente úteis. Um sistema mais barato não representa economia se a equipe precisar corrigir suas respostas ou se os clientes desistirem porque ele é lento.
Vá além do preço anunciado:
- API: cobranças de uso, ferramentas ou serviços adicionais, solicitações repetidas e o trabalho de criar e manter sua aplicação.
- GPU: capacidade alugada, computação e armazenamento de suporte, cobranças de rede, manutenção do software e tempo da equipe — incluindo capacidade de backup, se necessário.
Considere quanta capacidade permanece ociosa. Uma carga de trabalho constante pode justificar uma GPU reservada; picos ocasionais talvez não. Não existe um único nível de tráfego em que o hardware dedicado se torne mais barato para toda organização.
Três exemplos do dia a dia
Estas são situações ilustrativas, não histórias de clientes nem resultados prometidos.
1. Um assistente de atendimento ao cliente com demanda imprevisível. Comece avaliando uma API se um modelo disponível responder bem e atender aos seus requisitos de dados. Verifique se ele consegue lidar com períodos de alta demanda sem longas esperas.
2. Classificação de documentos todas as noites. Uma tarefa pequena e previsível usa um modelo adequado ao seu negócio e pode esperar até a manhã. A capacidade de GPU compartilhada pode ser suficiente, desde que tenha memória suficiente e conclua o trabalho no prazo.
3. Um serviço de IA usado ao longo do dia. Seu próprio modelo processa um fluxo constante de solicitações e os usuários esperam respostas rápidas. Teste uma capacidade dedicada, mas confirme a melhoria e os custos operacionais antes de se comprometer.
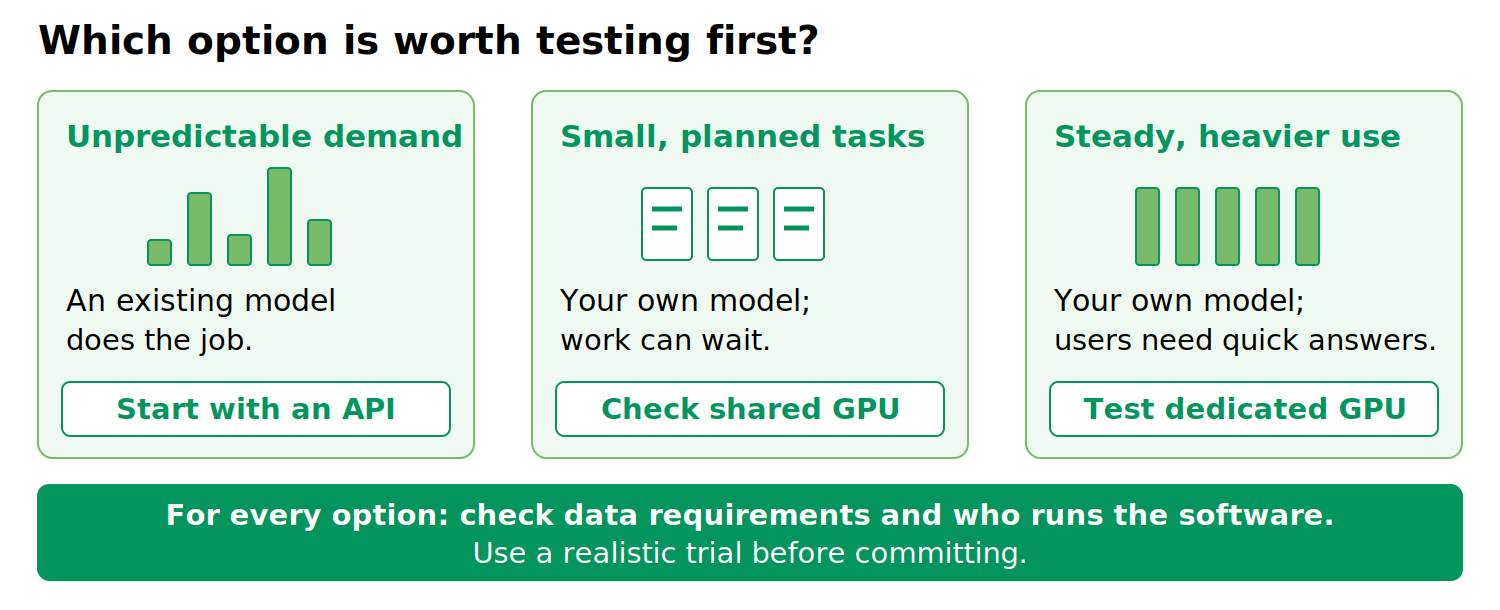
Figura 2. Estes são pontos de partida para um teste, não regras fixas. Os requisitos de dados e as responsabilidades pelo software importam em todos os casos.
Cinco perguntas antes de escolher
O que a IA precisa fazer bem?
Defina resultados úteis e tempos de espera aceitáveis.
Qual será o nível de utilização?
Inclua picos, períodos tranquilos e vários usuários chegando ao mesmo tempo.
Quem manterá tudo funcionando?
Defina a responsabilidade por atualizações, segurança, monitoramento e recuperação.
Para onde os dados irão?
Verifique processamento, registros, armazenamento, retenção e provedores de backup. Um ponto de acesso na UE, por si só, não prova que todas as partes do serviço permaneçam na UE; verifique também os contratos.
O que um teste realista mostra?
Compare a qualidade das respostas, os tempos de espera e o custo total para concluir a tarefa.
Converse com a CloudSigma sobre sua carga de trabalho de IA
A plataforma da CloudSigma descreve o GPU passthrough — acesso direto à GPU por uma máquina virtual — e as partições de GPU. A configuração e o comportamento de compartilhamento de uma partição precisam ser confirmados para a implementação selecionada. As opções disponíveis dependem da localização, do hardware e do acordo de serviço. Confirme quem executa o software de IA antes de escolher.
O CloudSigma AI Mission Control é uma camada separada de acesso e supervisão para serviços de IA gerenciados compatíveis e conexões diretas selecionadas com provedores. O CloudSigma AI Mission Control fornece uma camada de acesso e supervisão para serviços de IA gerenciados compatíveis e conexões diretas selecionadas com provedores. Ele oferece suporte a políticas que regem o acesso a modelos, fornecedores e regiões, além de acompanhar o uso por projeto. A conexão de uma capacidade de GPU pertencente ao cliente é um processo separado de integração assistida, com análise de arquitetura, fornecimento de modelos, segurança e operação — não uma configuração automática de autoatendimento.
Pronto para avaliar suas opções de implementação de IA? Fale com a CloudSigma sobre sua carga de trabalho, demanda esperada, requisitos do modelo e necessidades de localização dos dados. Juntos, vocês poderão identificar opções adequadas e definir os próximos passos para a avaliação.
Comments
No comments yet. Be the first.