時折顧客からの質問に答える AI アシスタントと、一日中リクエストを処理するサービスでは、必要なものが異なります。適切な選択は、最大の GPU ではなく、業務内容、予想される需要、そして誰がテクノロジーを管理するかから始まります。
GPU は、多くの AI タスクを実行するために使用される高性能なチップです。AI モデルは、それらのタスクを実行するソフトウェアです。API は、モデル自体を実行せずにアプリケーションから AI サービスを利用できるようにする接続です。
実際に何を選択しているのか?
マネージド AI API では、すぐに利用できるサービスにアクセスします。共有 GPU または専用 GPU では、コンピューティング容量を借り、AI ソフトウェアを自分で管理する必要がある場合があります。
API サービスは、共有ハードウェアまたは専用ハードウェア上で実行できます。 重要な問いは、誰がサービスを運用するのか、そしてワークロードにどれだけの容量が必要なのかです。
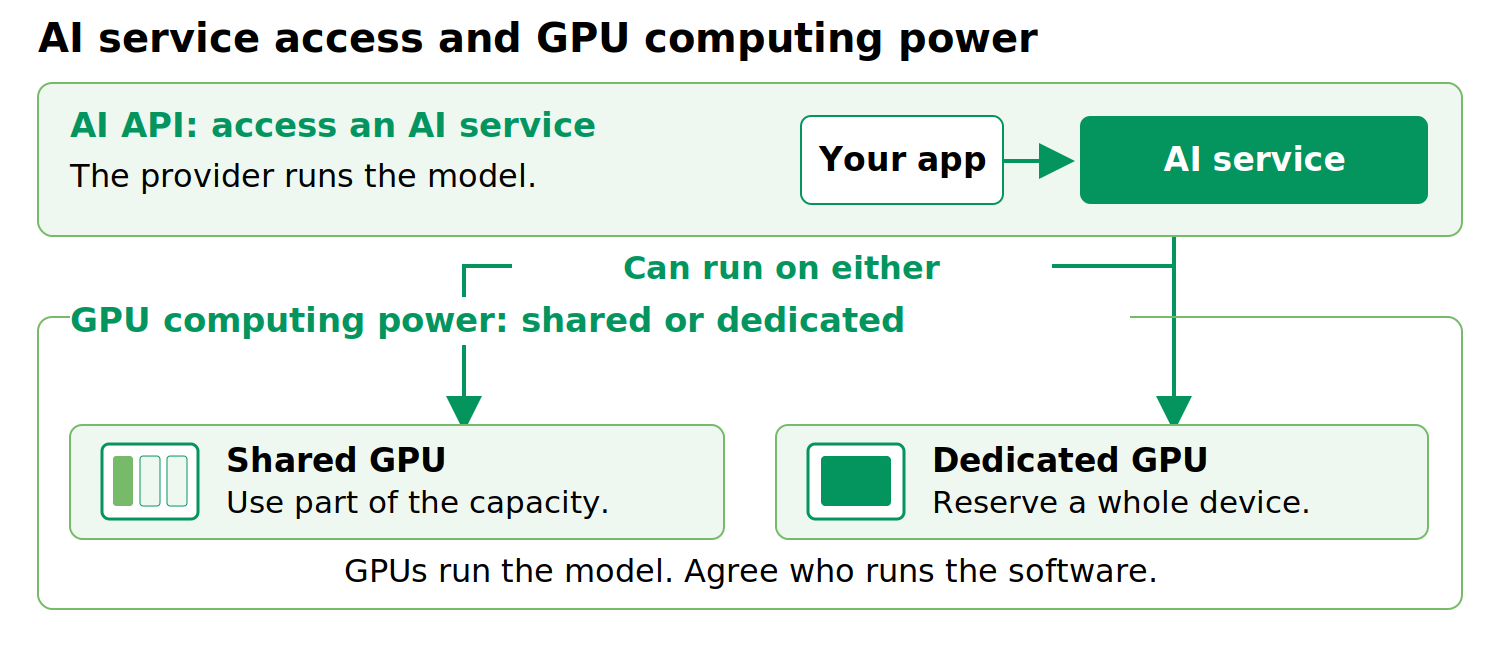
図 1. 異なる 2 つの選択:利用する AI サービスと、その下で稼働する GPU 容量。
始めるための 3 つの方法
選択肢 1:AI をサービスとして利用する
マネージド API を使うと、チームはアプリケーションを対応モデルに接続できます。モデルはプロバイダーが実行しますが、アプリケーション、アクセス権限、そして回答が十分に適切かどうかの確認については、引き続き利用者が責任を負います。
これは、需要が不確実または変動する場合に適しています。利用を決定する前に、利用制限、繁忙期の応答時間、プロバイダーがモデルを変更した場合に何が起こるかを確認してください。また、リクエストの送信先、アクセスできる人、データの保持期間についても確認しましょう。
選択肢 2:GPU 容量を共有する
共有 GPU サービスでは、ハードウェアの分割やタイムシェアリングなど、さまざまな方法でリソースを割り当てます。これらの方法では、分離レベルとパフォーマンスの予測可能性が異なります。ワークロードにどのリソースが割り当てられるのか、また他のユーザーがパフォーマンスにどのような影響を与える可能性があるのかを、プロバイダーに確認してください。
共有にはさまざまな形態があります。ハードウェア上で分離された一部を提供するサービスもあれば、処理時間を共有するサービスもあります。これらは、同一の保護やパフォーマンスを提供するものではありません。NVIDIA のドキュメントでは、これらのアプローチが区別されています。
どれだけのメモリと処理能力を受け取れるのか、他の顧客が作業に影響を与える可能性があるのか、AI ソフトウェアを誰が保守するのかを確認してください。「共有」というだけでは答えは分かりません。
選択肢 3:チーム用に GPU を確保する
専用 GPU は作業用にチップ全体を確保しますが、サーバー全体が専用になるとは限りません。安定した需要、大規模なモデル、または特別に構成された AI 環境を必要とするアプリケーションでは、検討する価値があります。
これらのサービスが含まれていない限り、ソフトウェアのインストール、更新、監視、復旧を行う担当者が必要です。専用 GPU だからといって、自動的に高速、安全、または法令に準拠するわけではありません。障害発生時の対応も含め、サービス全体をテストしてください。
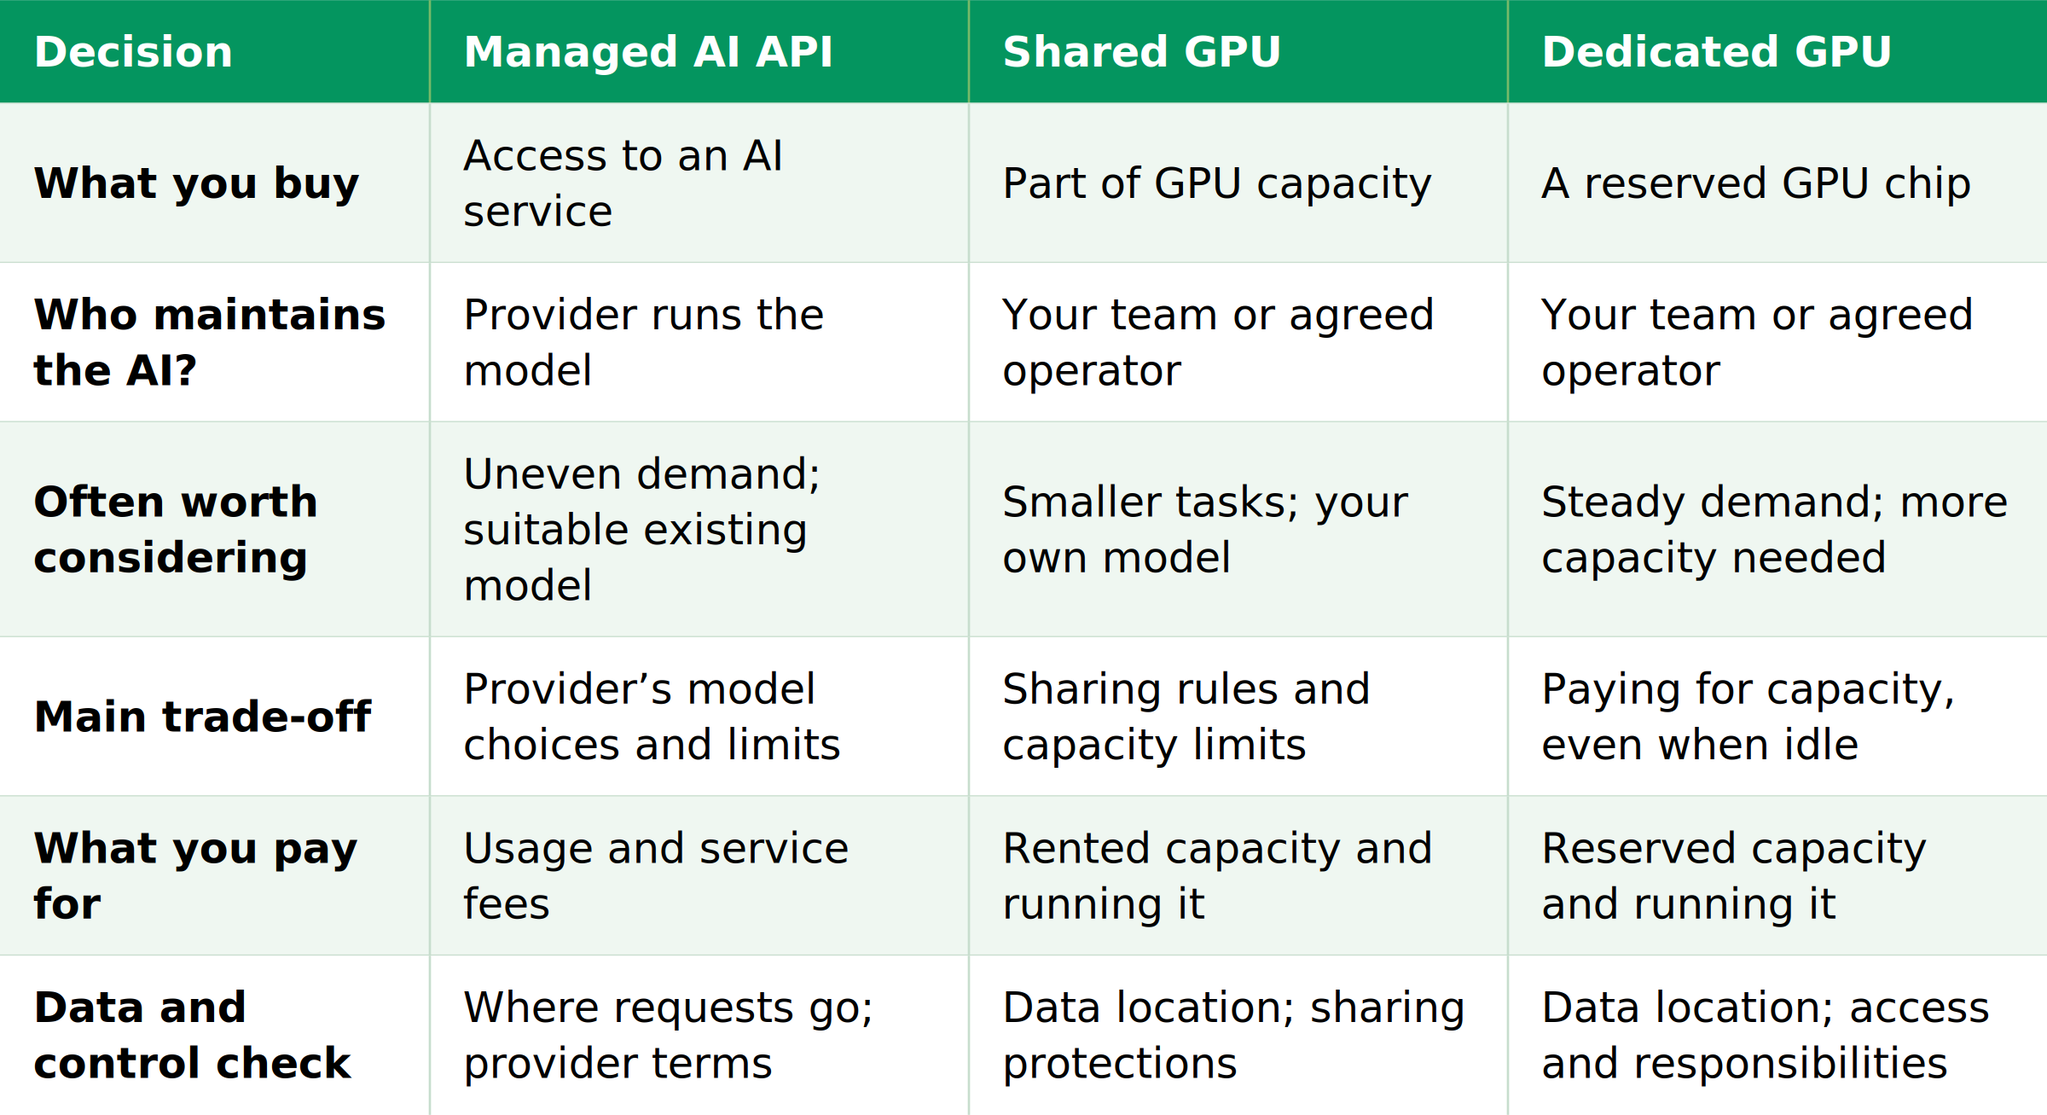
選択肢を一覧で比較する
以下の GPU の選択肢については、別途マネージドサービスを購入しない限り、チームが AI ソフトウェアを実行すると仮定します。
業務に本当に必要なものを確認する
技術仕様ではなく、役立つ回答から始めましょう。実際のタスクを試し、許容できる品質、利用者が待てる時間、同時にサービスを利用する可能性のある人数を判断します。
メモリも重要です。短いリクエスト 1 件では GPU に収まるモデルでも、長い文書や複数の同時利用者に対応するには、より多くのメモリが必要になる場合があります。技術チームまたはプロバイダーに、ワークロード全体を確認してもらいましょう。
タイミングによって判断は変わります。夜間処理はキューで待機できますが、ライブ回答を待つ顧客は通常待てません。静かなデモだけでなく、繁忙期もテストしてください。
モデルの適応やトレーニングには、単にモデルを使用する場合とは異なるリソースが必要になることがあります。その目的で容量を借りる前に、実現可能性、ソフトウェア互換性、モデルライセンスを確認してください。
総コストを比較する
同程度に有用な結果を提供する選択肢を比較してください。スタッフが回答を修正する必要があったり、遅さが原因で顧客が利用をやめたりするなら、安価なシステムでも節約にはなりません。
表示価格だけで判断しないでください:
- API:利用料金、ツールや追加サービスの費用、繰り返しのリクエスト、アプリケーションの構築・保守作業。
- GPU:レンタル容量、補助的なコンピューティングとストレージ、ネットワーク料金、ソフトウェア保守、スタッフの時間(必要に応じたバックアップ容量を含む)。
使用されない容量がどの程度あるかを考慮してください。安定したワークロードなら専用 GPU が正当化される可能性がありますが、時折発生する急増には適さないかもしれません。すべての組織において、専用ハードウェアの方が安くなる単一のトラフィック水準はありません。
日常的な 3 つの例
これらは説明のための状況であり、顧客事例や結果の保証ではありません。
1. 需要が予測できない顧客サポートアシスタント。利用可能なモデルが適切に回答し、データ要件を満たすなら、まず API の評価から始めます。長い待ち時間なしで繁忙期に対応できるかを確認してください。
2. 毎晩の文書分類。小規模で予測可能なタスクには、ビジネスに適したモデルを使用でき、朝まで待機させることもできます。十分なメモリがあり、時間内に完了できるなら、共有 GPU 容量が適している可能性があります。
3. 一日を通して使用される AI サービス。自社モデルが安定したリクエストを処理し、ユーザーは素早い回答を期待しています。専用容量をテストしますが、契約する前に改善効果と運用コストを確認してください。
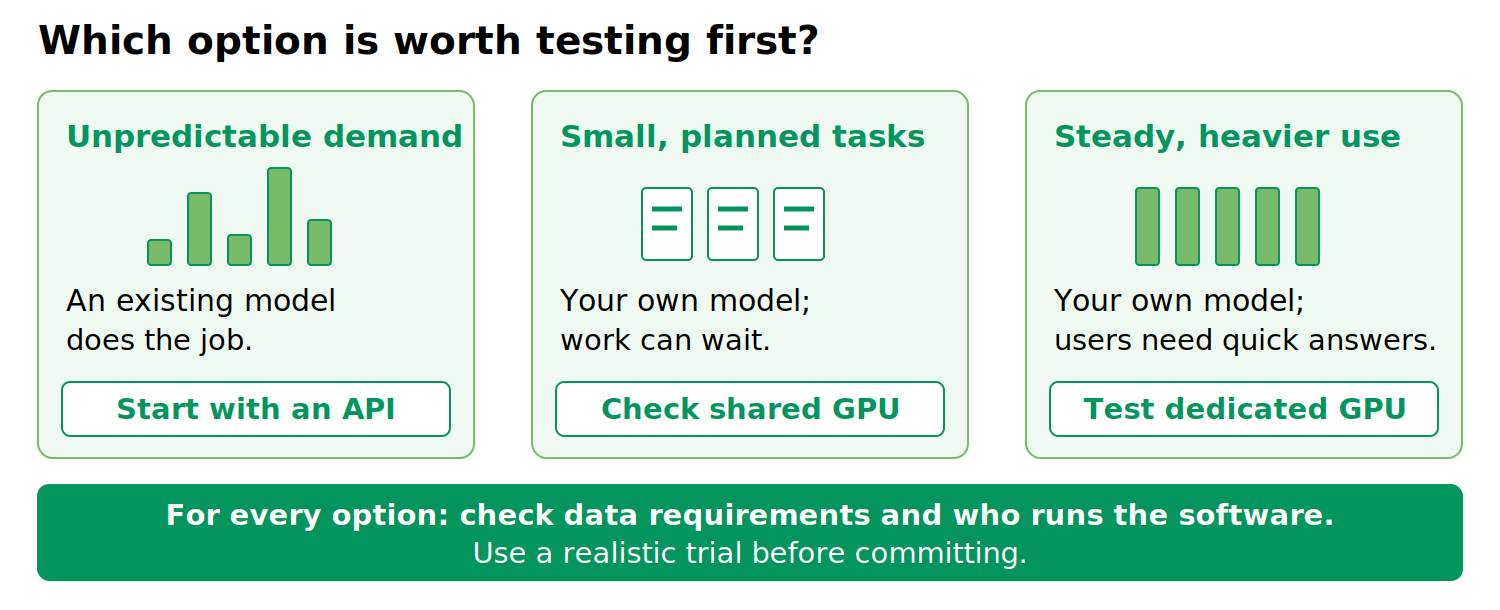
図 2. これらは試行の出発点であり、固定的なルールではありません。どの場合でも、データ要件とソフトウェアの責任分担が重要です。
選択前に確認すべき 5 つの質問
AI に何を適切に実行させる必要がありますか?
役立つ結果と許容できる待ち時間を定義します。
どの程度の負荷になりますか?
ピーク時、閑散期、複数のユーザーが同時にアクセスする場合を含めます。
誰が稼働を維持しますか?
更新、セキュリティ、監視、復旧の責任者を合意します。
データはどこに送られますか?
処理、ログ、ストレージ、保持、バックアッププロバイダーを確認します。EU のアクセスポイントだけでは、サービスのすべての部分が EU 内にとどまることの証明にはなりません。契約も確認してください。
現実的な試行で何が分かりますか?
回答品質、待ち時間、タスク完了にかかる総コストを比較します。
AI ワークロードについて CloudSigma に相談する
CloudSigma のプラットフォームでは、GPU パススルー(仮想マシンから GPU に直接アクセスする機能)と GPU スライスについて説明しています。スライスの構成と共有動作については、選択した導入環境で確認する必要があります。利用可能な選択肢は、場所、ハードウェア、サービス構成によって異なります。選択前に、AI ソフトウェアを誰が実行するのかを確認してください。
CloudSigma AI Mission Controlは、対応するマネージド AI サービスおよび選択されたプロバイダーへの直接接続のための、独立したアクセス・監視レイヤーです。CloudSigma AI Mission Control は、対応するマネージド AI サービスおよび選択されたプロバイダーへの直接接続のためのアクセス・監視レイヤーを提供します。モデル、サプライヤー、リージョンへのアクセスを管理するポリシーに対応し、プロジェクトごとの利用状況を追跡します。顧客所有の GPU 容量を接続する場合は、別途支援付きオンボーディングプロセスが必要です。アーキテクチャ、モデル提供、セキュリティ、運用のレビューが行われ、自動的なセルフサービス設定ではありません。
AI 導入の選択肢を評価する準備はできていますか?ワークロード、予想される需要、モデル要件、データ所在地のニーズについて、CloudSigma に相談してください。適切な選択肢を特定し、評価の次のステップを一緒に決定できます。
Comments
No comments yet. Be the first.