Un assistente AI che risponde a poche domande occasionali dei clienti ha esigenze diverse da un servizio che gestisce richieste tutto il giorno. La scelta giusta parte dal compito da svolgere, dalla domanda prevista e da chi si occuperà della tecnologia, non dalla GPU più grande.
Una GPU è un potente chip utilizzato per eseguire molte attività di AI. Un modello di AI è il software che svolge tali attività. Un'API è una connessione che permette alla tua applicazione di utilizzare un servizio di AI senza eseguire direttamente il modello.
Che cosa stai davvero scegliendo?
Con un'API AI gestita accedi a un servizio già pronto all'uso. Con le GPU condivise o dedicate affitti capacità di calcolo e potresti dover gestire tu stesso il software di AI.
Un servizio API può funzionare su hardware condiviso o dedicato. Le domande chiave sono chi gestisce il servizio e quale capacità richiede il tuo carico di lavoro.
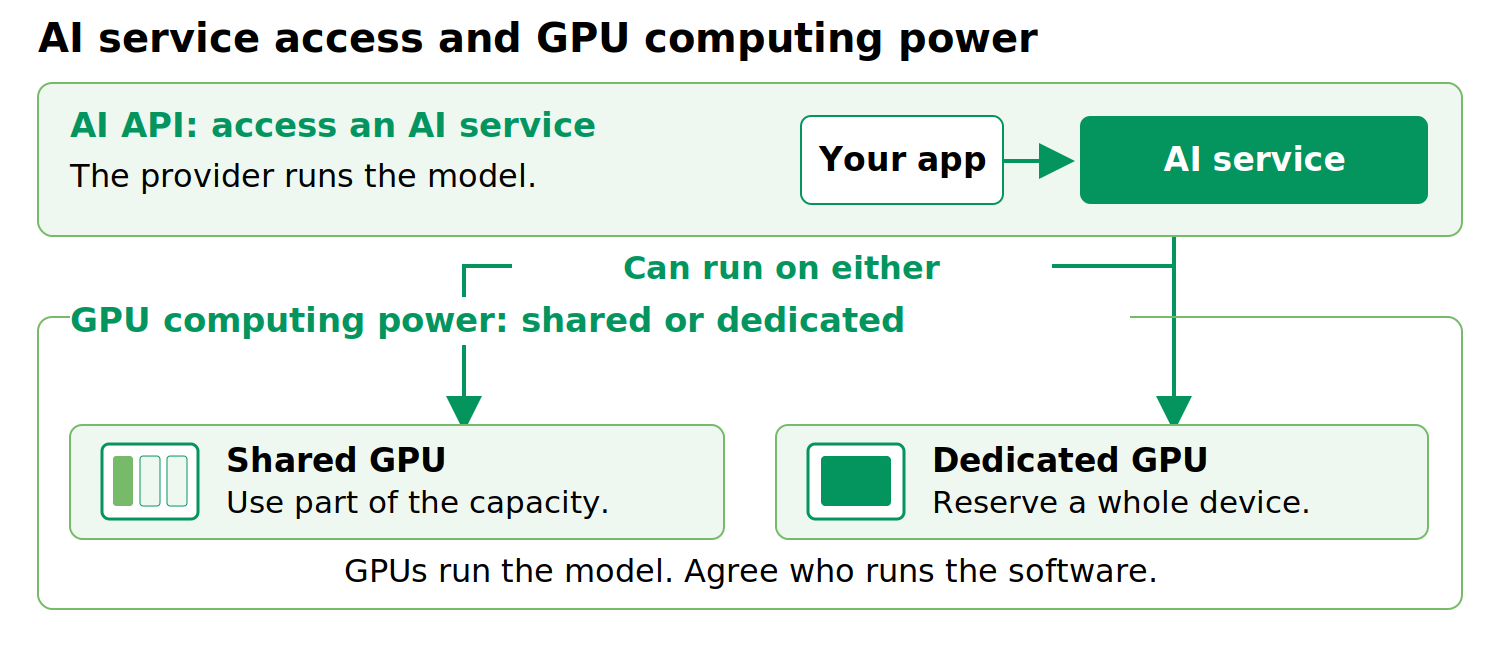
Figura 1. Due decisioni diverse: il servizio di AI che utilizzi e la capacità GPU sottostante.
Tre modi per iniziare
Opzione 1: usare l'AI come servizio
Un'API gestita permette al tuo team di collegare un'applicazione a un modello supportato. Il provider esegue il modello; tu rimani responsabile dell'applicazione, dei permessi di accesso e della verifica che le risposte siano sufficientemente valide.
Può essere adatta a una domanda incerta o irregolare. Prima di impegnarti, verifica i limiti di utilizzo, i tempi di risposta nei periodi di punta e cosa accade quando il provider modifica un modello. Chiedi anche dove vanno le richieste, chi può accedervi e per quanto tempo i dati vengono conservati.
Opzione 2: condividere la capacità GPU
I servizi GPU condivisi possono allocare le risorse in modi diversi, tra cui il partizionamento hardware o la condivisione del tempo di elaborazione. Questi approcci offrono livelli diversi di isolamento e prevedibilità delle prestazioni. Chiedi al provider quali risorse vengono allocate al tuo carico di lavoro e in che modo gli altri utenti possono influire sulle prestazioni.
La condivisione funziona in modi diversi. Alcuni servizi forniscono una porzione separata a livello hardware; altri condividono il tempo di elaborazione. Non offrono una protezione o prestazioni identiche. La documentazione di NVIDIA distingue questi approcci.
Chiedi quanta memoria e capacità di elaborazione ricevi, se altri clienti possono influenzare il tuo lavoro e chi gestisce il software di AI. «Condivisa» da sola non fornisce la risposta.
Opzione 3: riservare una GPU per il tuo team
Una GPU dedicata riserva un intero chip per il tuo lavoro, anche se non necessariamente l'intero server. Vale la pena considerarla per una domanda costante, modelli più grandi o applicazioni che richiedono un ambiente di AI configurato in modo specifico.
Hai comunque bisogno di qualcuno che installi, aggiorni, monitori e ripristini il software, a meno che questi servizi siano inclusi. Una GPU dedicata non è automaticamente più veloce, più sicura o conforme alle normative. Testa il servizio completo, compreso ciò che accade durante un guasto.
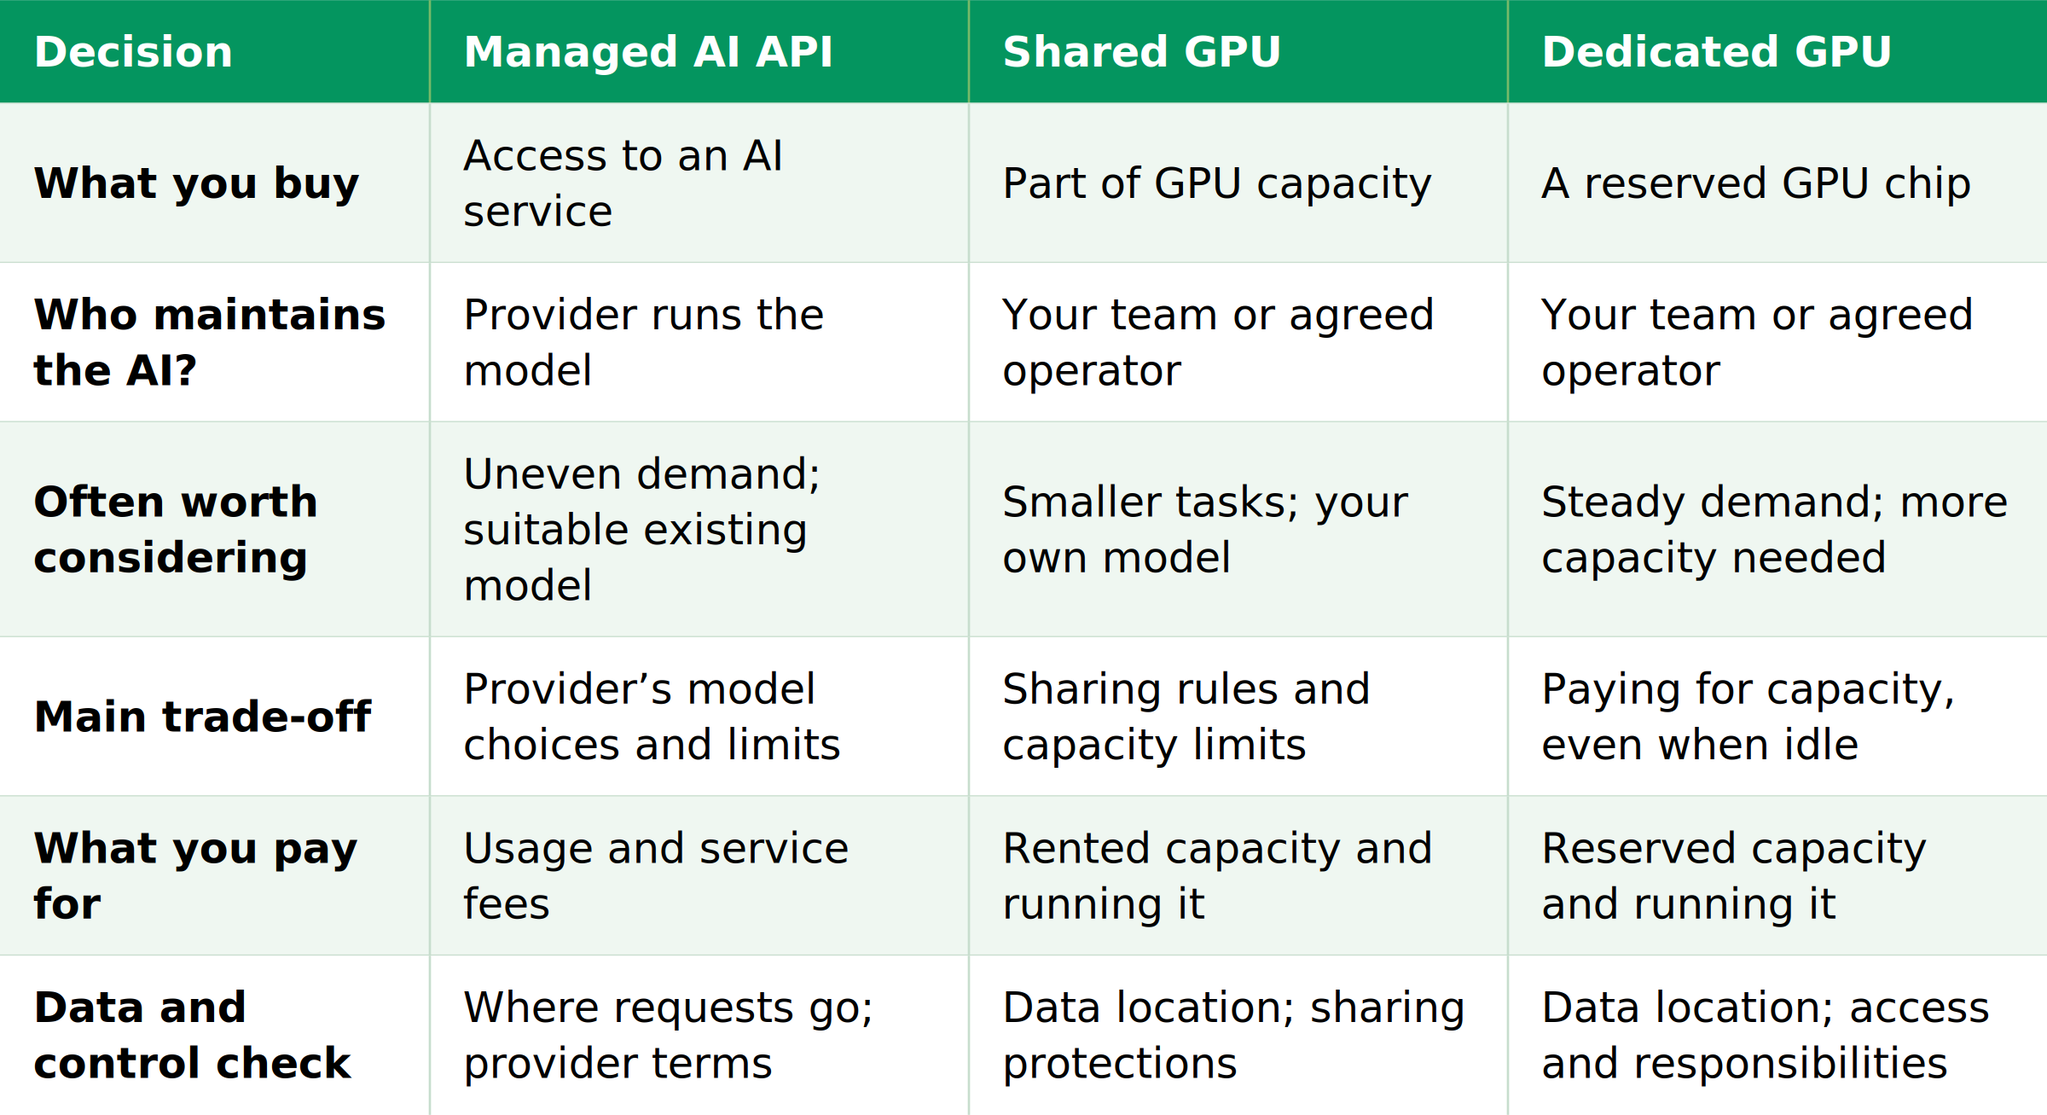
Confronta le opzioni a colpo d'occhio
Per le opzioni GPU riportate di seguito, si presume che il tuo team gestisca il software di AI, a meno che tu non acquisti un servizio gestito separato.
Verifica di cosa ha davvero bisogno il lavoro
Parti da risposte utili, non da specifiche tecniche. Prova attività reali e stabilisci quale qualità è accettabile, quanto le persone possono attendere e quante persone possono usare il servizio contemporaneamente.
Anche la memoria conta. Un modello che entra in una GPU per una singola richiesta breve può richiedere più memoria per documenti lunghi o per più utenti simultanei. Chiedi al tuo team tecnico o al provider di verificare l'intero carico di lavoro.
I tempi cambiano la decisione. L'elaborazione notturna può attendere in coda; un cliente che aspetta una risposta in tempo reale di solito no. Testa i periodi di punta oltre a una dimostrazione in un momento tranquillo.
Adattare o addestrare un modello può richiedere risorse diverse rispetto al semplice utilizzo. Verifica la fattibilità, la compatibilità del software e le licenze del modello prima di affittare capacità a questo scopo.
Confronta il costo complessivo
Confronta opzioni che offrono risultati ugualmente utili. Un sistema più economico non è un risparmio se il personale deve correggerne le risposte o se i clienti lo abbandonano perché è lento.
Guarda oltre il prezzo di listino:
- API: costi di utilizzo, eventuali strumenti o servizi aggiuntivi, richieste ripetute e il lavoro di sviluppo e manutenzione della tua applicazione.
- GPU: capacità affittata, calcolo e storage di supporto, costi di rete, manutenzione del software e tempo del personale, inclusa la capacità di riserva se necessaria.
Considera quanta capacità resta inutilizzata. Un carico di lavoro costante può giustificare una GPU riservata; picchi occasionali potrebbero non farlo. Non esiste un unico livello di traffico oltre il quale l'hardware dedicato diventa più conveniente per ogni organizzazione.
Tre esempi quotidiani
Si tratta di situazioni illustrative, non di casi reali di clienti né di risultati garantiti.
1. Un assistente per l'assistenza clienti con domanda imprevedibile. Inizia valutando un'API se un modello disponibile risponde bene e soddisfa i tuoi requisiti sui dati. Verifica se riesce a gestire i periodi di punta senza lunghe attese.
2. Smistare documenti ogni notte. Un'attività piccola e prevedibile utilizza un modello adatto alla tua azienda e può attendere fino al mattino. La capacità GPU condivisa può essere adatta, purché abbia memoria sufficiente e termini in tempo.
3. Un servizio di AI utilizzato per tutto il giorno. Il tuo modello gestisce un flusso costante di richieste e gli utenti si aspettano risposte rapide. Testa la capacità dedicata, ma verifica il miglioramento e i costi di gestione prima di impegnarti.
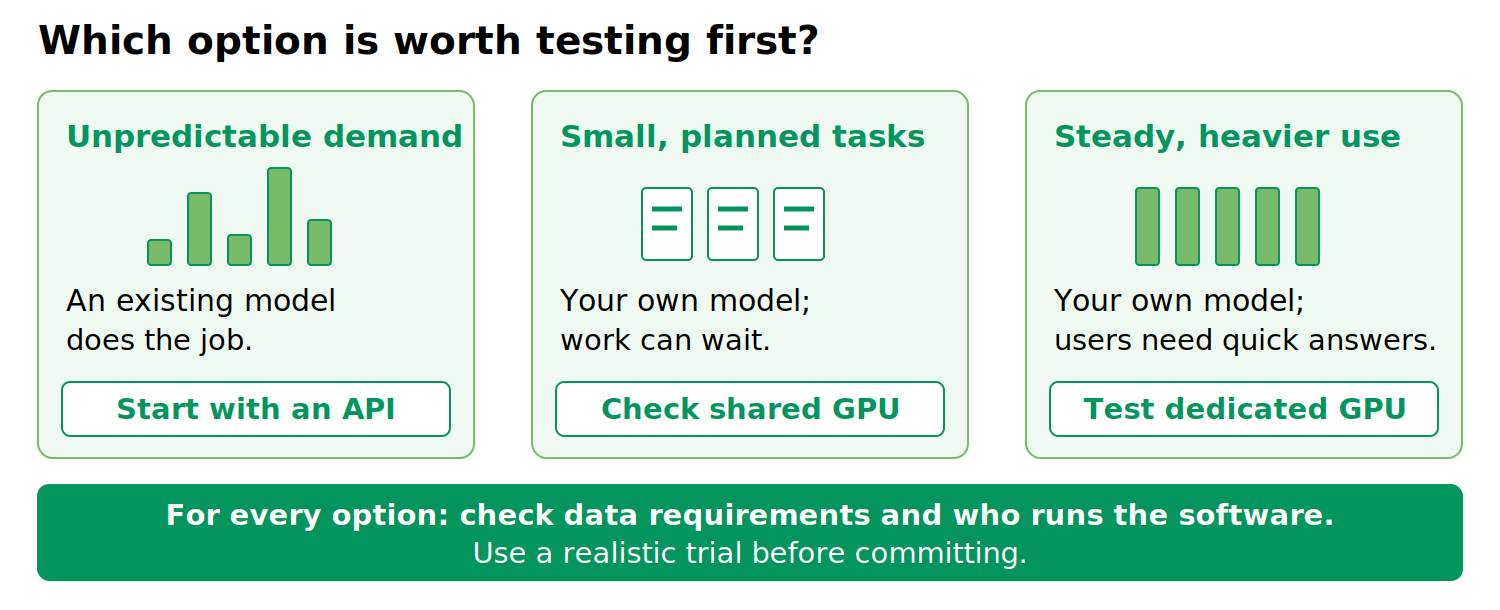
Figura 2. Questi sono punti di partenza per una prova, non regole fisse. I requisiti sui dati e le responsabilità sul software contano in ogni caso.
Cinque domande prima di scegliere
Che cosa deve fare bene l'AI?
Definisci i risultati utili e i tempi di attesa accettabili.
Quanto sarà intenso l'utilizzo?
Includi i picchi, i periodi tranquilli e più utenti che arrivano insieme.
Chi lo manterrà in funzione?
Concorda la responsabilità per aggiornamenti, sicurezza, monitoraggio e ripristino.
Dove andranno i dati?
Verifica elaborazione, log, storage, conservazione e provider di backup. Un punto di accesso nell'UE da solo non dimostra che ogni parte del servizio resti nell'UE; controlla anche i contratti.
Che cosa mostra una prova realistica?
Confronta qualità delle risposte, tempi di attesa e costo complessivo per completare l'attività.
Parla del tuo carico di lavoro AI con CloudSigma
La piattaforma di CloudSigma descrive il GPU passthrough, ovvero l'accesso diretto alla GPU per una macchina virtuale, e le GPU slice. La configurazione e il comportamento di condivisione di una slice devono essere confermati per la distribuzione selezionata. Le opzioni disponibili dipendono da ubicazione, hardware e accordo di servizio. Conferma chi gestisce il software di AI prima di scegliere.
CloudSigma AI Mission Control è un livello separato di accesso e supervisione per i servizi di AI gestiti supportati e per alcune connessioni dirette ai provider selezionati. CloudSigma AI Mission Control fornisce un livello di accesso e supervisione per i servizi di AI gestiti supportati e per alcune connessioni dirette ai provider selezionati. Supporta policy che regolano l'accesso a modelli, fornitori e regioni e monitora l'utilizzo per progetto. Il collegamento della capacità GPU di proprietà del cliente è un processo separato di onboarding assistito, con revisione di architettura, model serving, sicurezza e operatività, e non una configurazione self-service automatica.
Pronto a valutare le tue opzioni di distribuzione dell'AI? Parla con CloudSigma del tuo carico di lavoro, della domanda prevista, dei requisiti del modello e delle esigenze di ubicazione dei dati. Insieme potrete individuare le opzioni adatte e concordare i prossimi passi per la valutazione.
Comments
No comments yet. Be the first.