Asystent AI, który sporadycznie odpowiada na pytania klientów, ma inne potrzeby niż usługa obsługująca żądania przez cały dzień. Właściwy wybór zaczyna się od zadania, przewidywanego zapotrzebowania i tego, kto będzie zajmować się technologią — a nie od największego GPU.
GPU to wydajny układ używany do wykonywania wielu zadań AI. Model AI to oprogramowanie, które realizuje te zadania. API to połączenie, które pozwala aplikacji korzystać z usługi AI bez samodzielnego uruchamiania modelu.
Co właściwie wybierasz?
W przypadku zarządzanego API AI korzystasz z gotowej usługi. W przypadku współdzielonych lub dedykowanych GPU wynajmujesz moc obliczeniową i możesz samodzielnie zarządzać oprogramowaniem AI.
Usługa API może działać na współdzielonym lub dedykowanym sprzęcie. Kluczowe pytania dotyczą tego, kto obsługuje usługę i jakiej mocy obliczeniowej wymaga Twoje obciążenie.
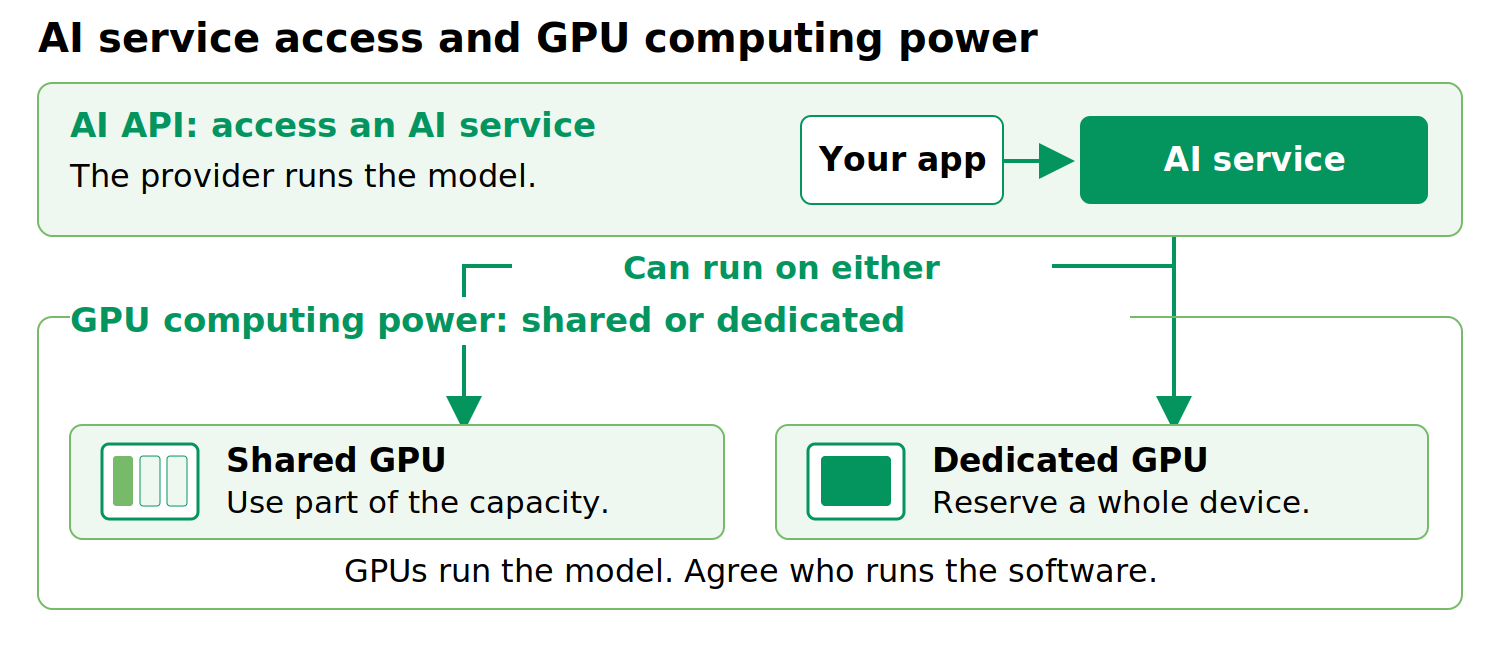
Rysunek 1. Dwie różne decyzje: usługa AI, z której korzystasz, oraz stojąca za nią moc obliczeniowa GPU.
Trzy sposoby na rozpoczęcie pracy
Opcja 1: Korzystanie z AI jako usługi
Zarządzane API umożliwia zespołowi połączenie aplikacji z obsługiwanym modelem. Dostawca uruchamia model, a Ty odpowiadasz za aplikację, uprawnienia dostępu i sprawdzenie, czy jego odpowiedzi są wystarczająco dobre.
To rozwiązanie może sprawdzić się przy niepewnym lub nierównomiernym zapotrzebowaniu. Przed podjęciem decyzji sprawdź limity użytkowania, czas odpowiedzi w okresach wzmożonego ruchu oraz to, co się stanie, gdy dostawca zmieni model. Zapytaj również, dokąd trafiają żądania, kto może uzyskać do nich dostęp i jak długo dane są przechowywane.
Opcja 2: Współdzielenie mocy obliczeniowej GPU
Współdzielone usługi GPU mogą przydzielać zasoby na różne sposoby, w tym poprzez partycjonowanie sprzętu lub współdzielenie czasu. Podejścia te oferują różny poziom izolacji i przewidywalności wydajności. Zapytaj dostawcę, jakie zasoby są przydzielone do Twojego obciążenia i jak inni użytkownicy mogą wpływać na wydajność.
Współdzielenie może działać na różne sposoby. Niektóre usługi zapewniają część oddzieloną sprzętowo, inne współdzielą czas przetwarzania. Nie gwarantują one identycznego poziomu ochrony ani wydajności. Dokumentacja NVIDIA rozróżnia te podejścia.
Zapytaj, ile pamięci i mocy obliczeniowej otrzymujesz, czy inni klienci mogą wpływać na Twoją pracę oraz kto utrzymuje oprogramowanie AI. Samo określenie „współdzielone” nie daje odpowiedzi.
Opcja 3: Rezerwacja GPU dla zespołu
Dedykowane GPU rezerwuje cały układ do Twoich zastosowań, choć niekoniecznie cały serwer. Warto rozważyć to rozwiązanie przy stałym zapotrzebowaniu, większych modelach lub aplikacjach wymagających specjalnie skonfigurowanego środowiska AI.
Nadal potrzebujesz kogoś, kto zainstaluje, zaktualizuje, będzie monitorować i przywróci oprogramowanie, chyba że usługi te są wliczone w ofertę. Dedykowane GPU nie jest automatycznie szybsze, bezpieczniejsze ani zgodne z wymogami prawnymi. Przetestuj całą usługę, w tym jej działanie w przypadku awarii.
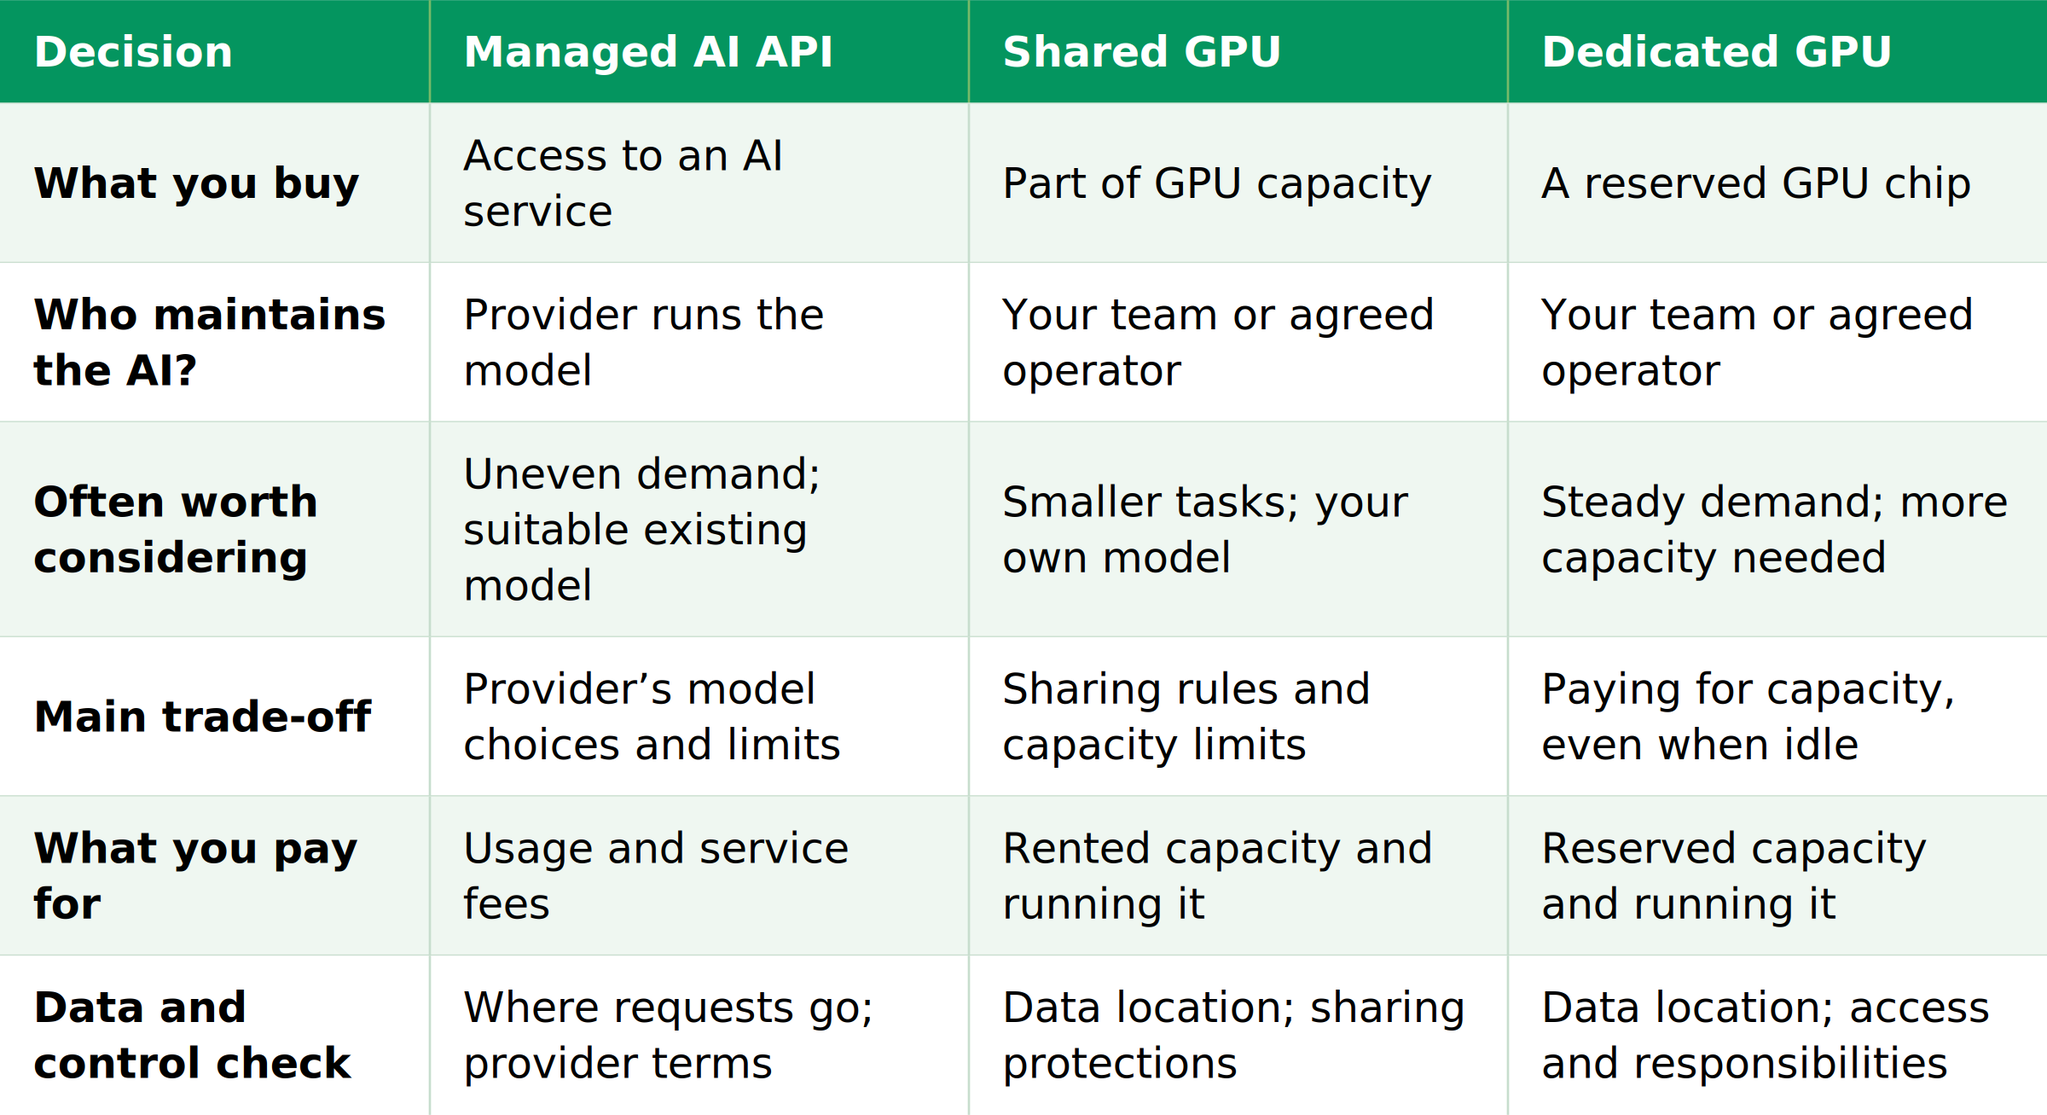
Szybkie porównanie opcji
W przypadku przedstawionych poniżej opcji GPU załóż, że Twój zespół uruchamia oprogramowanie AI, chyba że kupujesz oddzielną usługę zarządzaną.
Sprawdź rzeczywiste potrzeby zadania
Zacznij od przydatnych odpowiedzi, a nie od specyfikacji technicznej. Przetestuj rzeczywiste zadania i określ akceptowalną jakość, czas oczekiwania oraz liczbę osób, które mogą jednocześnie korzystać z usługi.
Pamięć również ma znaczenie. Model, który mieści się w pamięci GPU przy jednym krótkim żądaniu, może wymagać większej ilości pamięci podczas pracy z długimi dokumentami lub kilkoma użytkownikami jednocześnie. Poproś zespół techniczny lub dostawcę o sprawdzenie pełnego obciążenia.
Czas realizacji zmienia decyzję. Przetwarzanie nocne może czekać w kolejce, ale klient oczekujący na odpowiedź na żywo zazwyczaj nie może. Testuj zarówno okresy wzmożonego ruchu, jak i spokojną demonstrację.
Dostosowanie lub trenowanie modelu może wymagać innych zasobów niż samo korzystanie z niego. Przed wynajęciem mocy do tego celu sprawdź wykonalność, zgodność oprogramowania i licencje modelu.
Porównaj pełny koszt
Porównuj opcje zapewniające podobnie użyteczne rezultaty. Tańszy system nie oznacza oszczędności, jeśli pracownicy muszą poprawiać jego odpowiedzi lub klienci rezygnują z usługi z powodu jej powolnego działania.
Wyjdź poza cenę nagłówkową:
- API: opłaty za użytkowanie, narzędzia lub dodatkowe usługi, powtarzające się żądania oraz praca związana z tworzeniem i utrzymaniem aplikacji.
- GPU: wynajmowana moc, pomocnicze zasoby obliczeniowe i pamięć masowa, opłaty sieciowe, utrzymanie oprogramowania oraz czas pracy personelu — w tym dodatkowa moc na wypadek potrzeby.
Weź pod uwagę, ile mocy pozostaje niewykorzystanej. Stałe obciążenie może uzasadniać dedykowane GPU, ale sporadyczne skoki zapotrzebowania — niekoniecznie. Nie istnieje jeden poziom ruchu, przy którym dedykowany sprzęt staje się tańszy dla każdej organizacji.
Trzy przykłady z codziennej pracy
Są to sytuacje ilustracyjne, a nie historie klientów ani obietnice konkretnych rezultatów.
1. Asystent do obsługi klienta o nieprzewidywalnym zapotrzebowaniu. Zacznij od oceny API, jeśli dostępny model zapewnia dobre odpowiedzi i spełnia wymagania dotyczące danych. Sprawdź, czy może obsłużyć okresy wzmożonego ruchu bez długiego oczekiwania.
2. Sortowanie dokumentów każdej nocy. Niewielkie, przewidywalne zadanie wykorzystuje model dopasowany do potrzeb firmy i może poczekać do rana. Współdzielona moc GPU może być odpowiednia, pod warunkiem że zapewnia wystarczającą ilość pamięci i kończy pracę na czas.
3. Usługa AI używana przez cały dzień. Własny model obsługuje stały strumień żądań, a użytkownicy oczekują szybkich odpowiedzi. Przetestuj dedykowaną moc, ale przed podjęciem decyzji potwierdź poprawę oraz koszty działania.
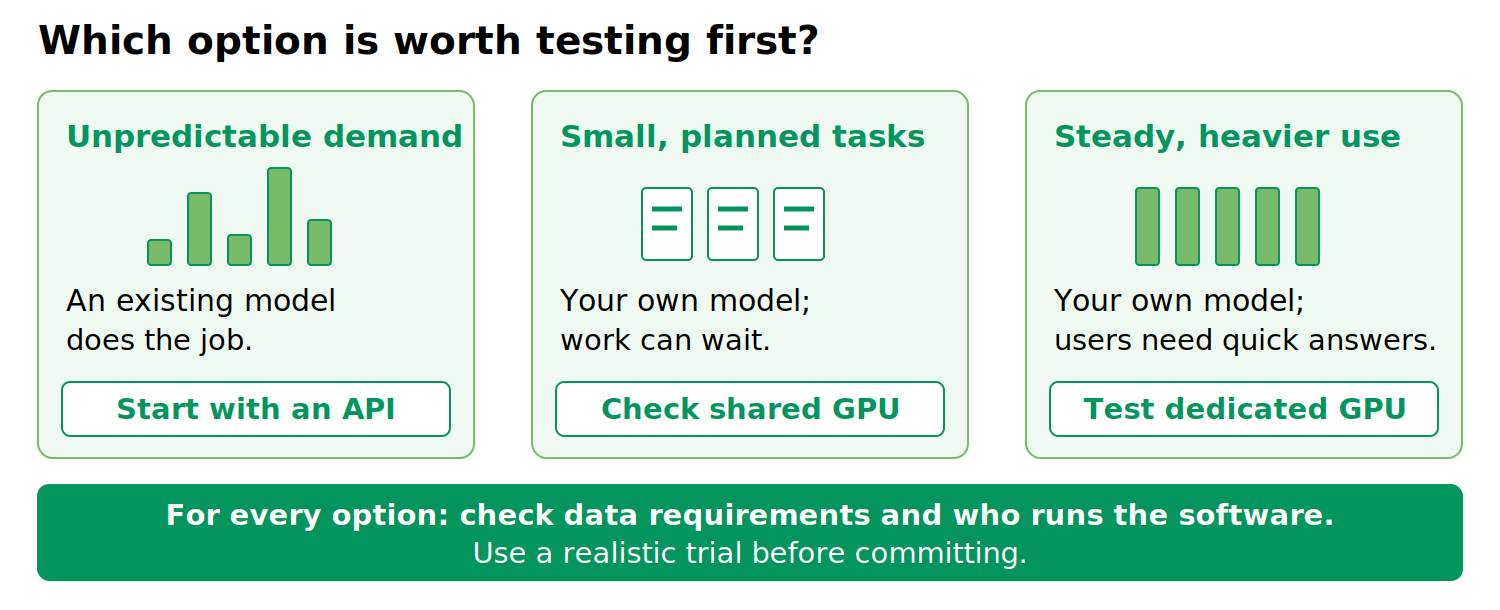
Rysunek 2. To punkty wyjścia do testów, a nie sztywne zasady. Wymagania dotyczące danych i odpowiedzialność za oprogramowanie mają znaczenie w każdym przypadku.
Pięć pytań przed dokonaniem wyboru
Co AI musi robić dobrze?
Zdefiniuj użyteczne rezultaty i akceptowalny czas oczekiwania.
Jak duże będzie obciążenie?
Uwzględnij szczyty, spokojne okresy oraz sytuacje, gdy kilku użytkowników pojawia się jednocześnie.
Kto będzie utrzymywać usługę?
Ustal odpowiedzialność za aktualizacje, bezpieczeństwo, monitorowanie i przywracanie działania.
Dokąd trafią dane?
Sprawdź przetwarzanie, dzienniki, pamięć masową, przechowywanie i dostawców kopii zapasowych. Sam punkt dostępu w UE nie dowodzi, że każda część usługi pozostaje w UE; sprawdź również umowy.
Co pokazuje realistyczny test?
Porównaj jakość odpowiedzi, czas oczekiwania i pełny koszt wykonania zadania.
Omów swoje obciążenie AI z CloudSigma
Platforma CloudSigma opisuje GPU passthrough — bezpośredni dostęp maszyny wirtualnej do GPU — oraz fragmenty GPU. Konfigurację i sposób współdzielenia fragmentu należy potwierdzić dla wybranego wdrożenia. Dostępne opcje zależą od lokalizacji, sprzętu i ustaleń dotyczących usługi. Przed dokonaniem wyboru potwierdź, kto uruchamia oprogramowanie AI.
CloudSigma AI Mission Control to oddzielna warstwa dostępu i nadzoru dla obsługiwanych zarządzanych usług AI oraz wybranych bezpośrednich połączeń z dostawcami. CloudSigma AI Mission Control zapewnia warstwę dostępu i nadzoru dla obsługiwanych zarządzanych usług AI oraz wybranych bezpośrednich połączeń z dostawcami. Obsługuje zasady regulujące dostęp do modeli, dostawców i regionów oraz śledzi wykorzystanie według projektu. Podłączenie mocy GPU należącej do klienta jest odrębnym procesem wspomaganego wdrożenia, obejmującym przegląd architektury, udostępniania modeli, bezpieczeństwa i działania — nie jest to automatyczna konfiguracja samoobsługowa.
Gotowy, aby ocenić opcje wdrażania AI? Skontaktuj się z CloudSigma, aby omówić swoje obciążenie, przewidywane zapotrzebowanie, wymagania dotyczące modelu i potrzeby związane z lokalizacją danych. Wspólnie możecie określić odpowiednie opcje i uzgodnić kolejne kroki oceny.
Comments
No comments yet. Be the first.